RabbitMQ 笔记
1 基本概念
1.1 为什么要用 MQ?
主要是因为 MQ 可以实现以下三种功能:
- 服务解耦:如 A 服务产生数据后要发送给下游的 B、C、D 服务:
- 使用传统模式:要一个一个调用给对方,如果新增或修改下游,还要修改代码,还要保证所有服务都可以收到,且下游服务直接依赖上游的服务 A。
- 使用 MQ:则 A 可以直接将消息发送到消息队列,下游需要时可主动去订阅服务,不需要时取消订阅即可。避免了服务之间的耦合。
- 流量削峰:如有一个应用,每秒最多可以处理 300 个请求,但高峰期突然会每秒产生 3000 个请求:
- 使用传统模式:需要增加到 10 台服务器来处理,不然请求可能会超时。但平时又用不到这么多服务器,动态扩容缩减服务器很麻烦且扩缩容本身也需要时间。
- 使用 MQ:可以将请求发送到消息队列中,然后根据自身的处理能力慢慢从消息队列中取消息来消费,这样对于客户端的请求不会一直在等待服务端处理,避免客户端请求超时。
- 异步调用:如用户下订单后,还需要做扣减余额、库存、通知发货等操作:
- 使用传统模式:依次调用对应服务的接口来处理,但每个服务处理时间不定,会导致客户端一直在等待。
- 使用 MQ:将信息发送到对应的消息队列中即可,每个服务取自己要处理的数据,客户端不用一直等待。相当于异步调用了其他服务的接口。
1.2 类似 MQ 产品
- Kafka:分布式消息队列,高吞吐量,适用于日志场景。
- RabbitMQ:基于 AMQP 协议,erlang 语言开发,老牌功能全、扩展多、稳定性好。
- RocketMQ:基于 JMS 协议,阿里出品,目前交由 Apache 基金会
2 安装
RabbitMQ 是使用 Erlang 语言开发的,可使用 docker-compose 进行安装:
version: '3.7'
services:
  rabbitmq:
    image: rabbitmq:3-management
    container_name: rabbitmq
    environment:
      RABBITMQ_DEFAULT_USER: admin
      RABBITMQ_DEFAULT_PASS: xxxxx
    ports:
      - 15672:15672
- 5672:5672image:tag 中带-management的是带管理网页的。environmentRABBITMQ_DEFAULT_PASS:默认用户名RABBITMQ_DEFAULT_PASS:默认密码
ports15672:http协议的管理页面断开5672:amqp协议的端口号,一般用于各个语言sdk连接。
docker-compose up -d 后可以访问 ip:15672 访问管理页面。
3 管理页面概述
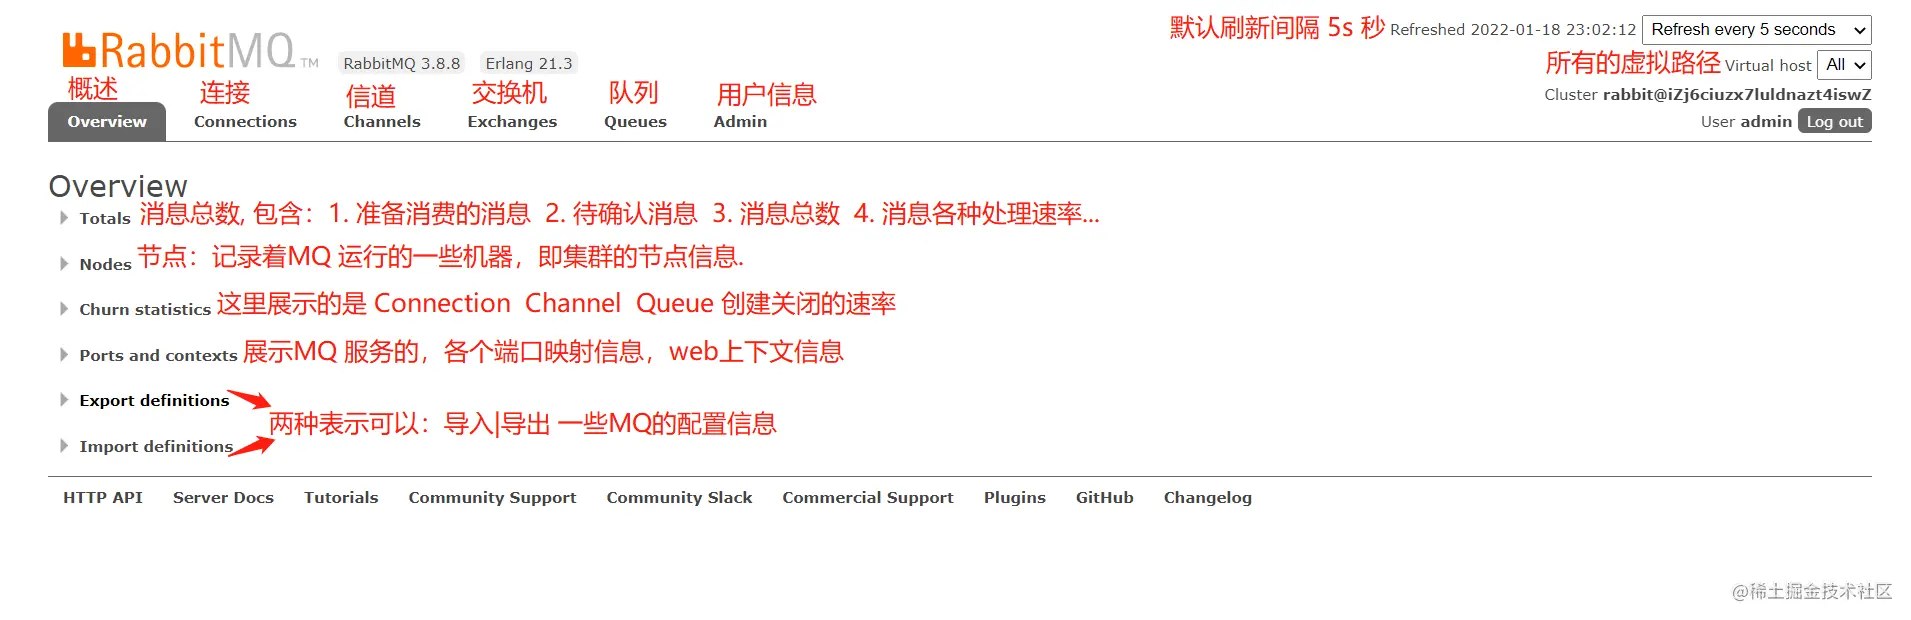
3.1 Overview
3.2 Connections
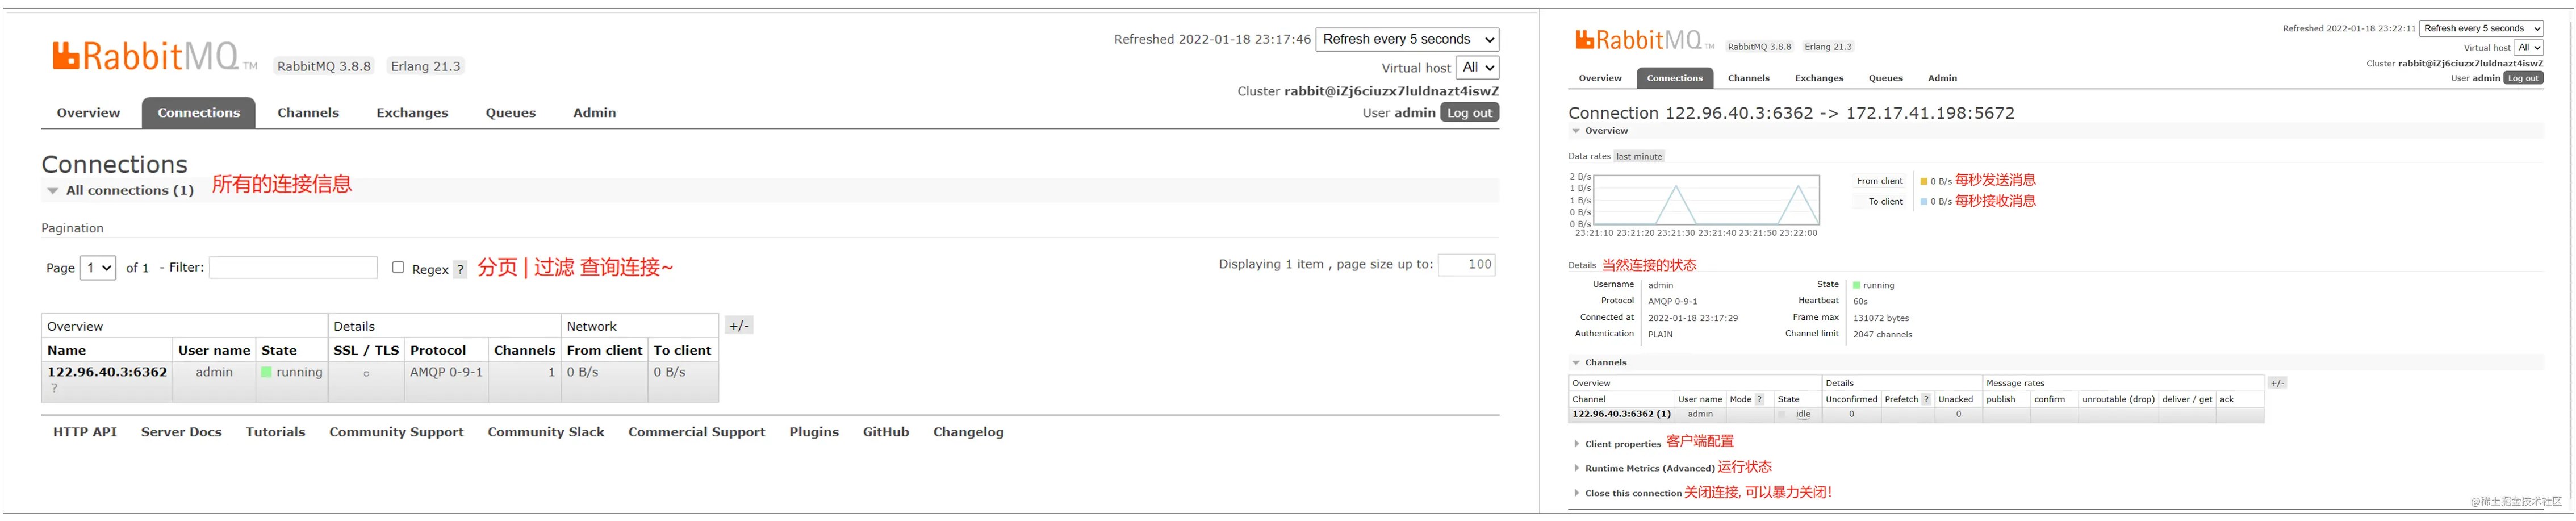
Name: 连接名,点击连接名, 还可以查看详细的信息User name: 当前连接登录 MQ 的用户State: 当前连接的状态,running 运行idle 空闲SSL|TLS: 是否使用的是SSL|TLS协议Protocol:AMQP 0-9-1指的是 AMQP 的协议版本号Channels: 当前连接创建的通道 (Channel) 数From client: 每秒发出的消息数To client: 每秒接收的消息数
3.3 Channels
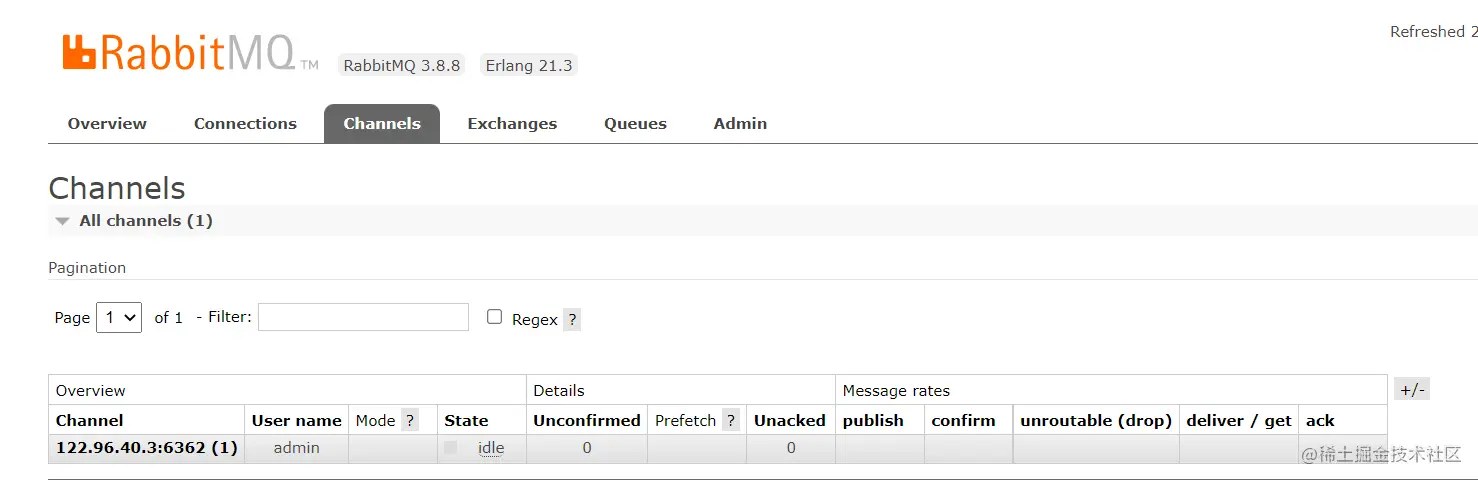
记录各个连接的信道:
一个连接IP 可以有多个信道 多个通道通过多线程实现,不相互干扰 生产者的通道一般使用完之后会立马关闭,消费者是一直监听的
Channel: 通道名称User name: 通道创建者用户名Model: 通道的确认模式C confirm模式T 表示事务State: 通道当前的状态running 运行idie 空闲Unconfirmed: 待确认的消息数Prefetch: 预取消息数 Prefetch 表示每个消费者最大的能承受的未确认消息数目 简单来说就是用来指定一个消费者一次可以从 RabbitMQ 中获取多少条消息并缓存在消费者中, 一旦消费者的缓冲区满了,RabbitMQ 将会停止投递新的消息到该消费者中直到它发出有消息被 ack 了 消费者负责不断处理消息,不断 ack,然后只要UnAcked数少于Prefetch * consumer数目,RabbitMQ 就不断将消息投递过去Unacker: 待 ack 的消息数publish: 消息生产者发送消息的速率confirm: 消息生产者确认消息的速率unroutable:drop表示消息,未被接收,且已经删除的消息deliver / get: 消息消费者获取消息的速率ack: 消息消费者 ack 消息的速率
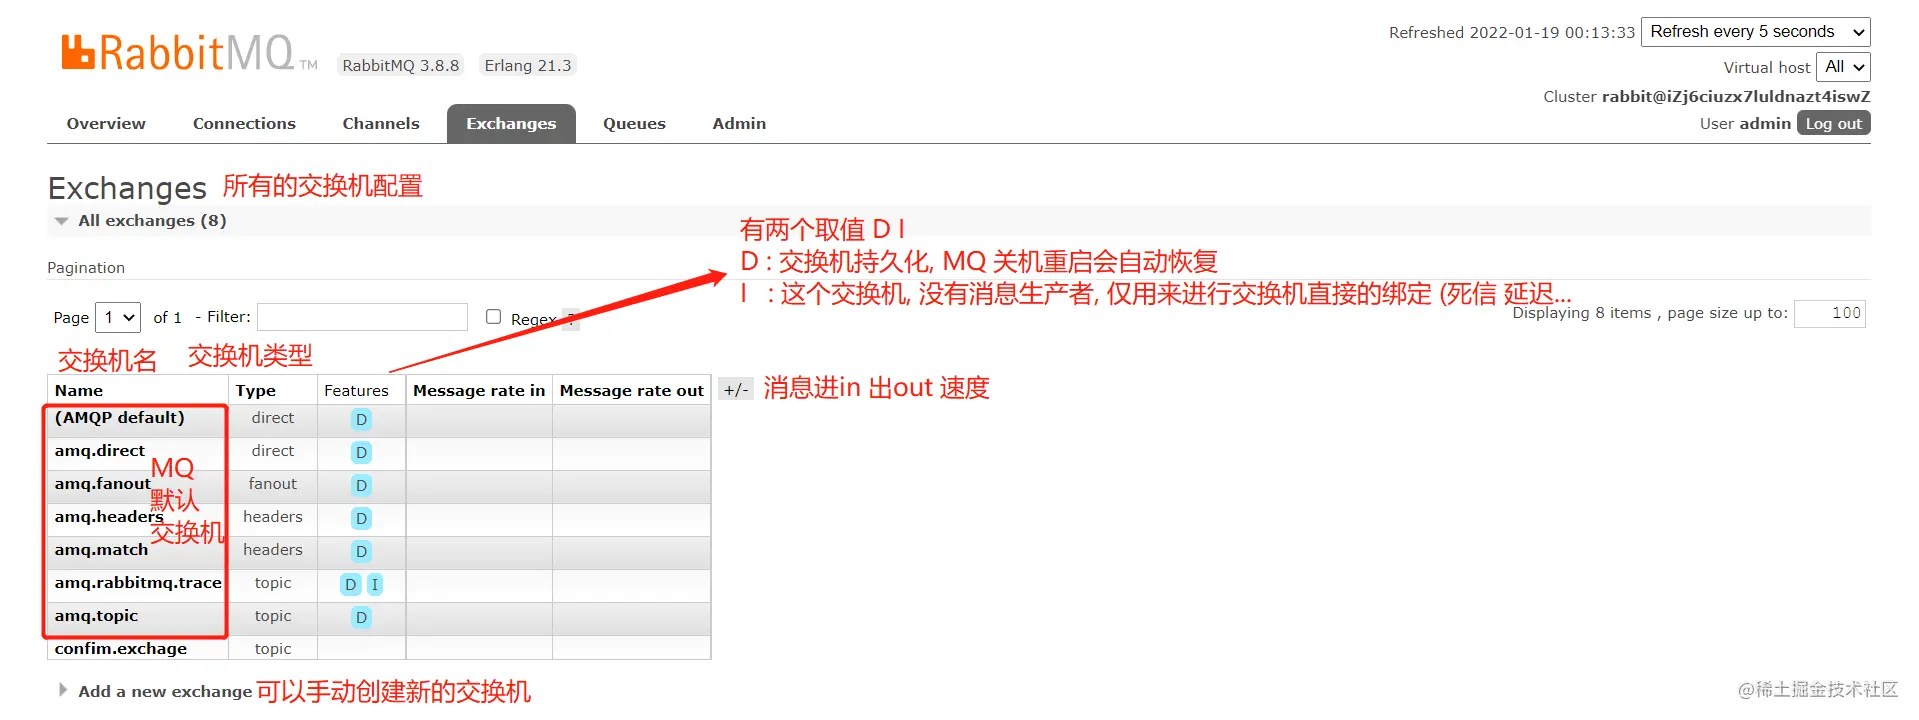
3.4 Exchange
3.5 Queue
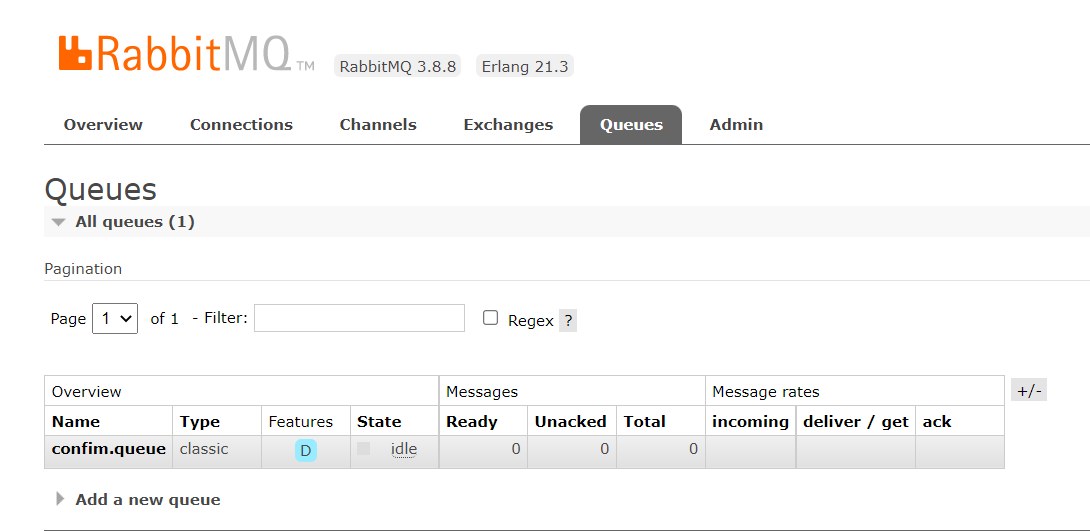
Name:表示消息队列的名称Type:消息队列的类型Features:表示消息队列的特性,D 表示消息队列持久化State:表示当前队列的状态,running 表示运行中,idle 表示空闲Ready:表示待消费的消息总数Unacked:表示待应答的消息总数Total:表示消息总数Ready+Unackedincoming:表示消息进入的速率deliver/get:表示获取消息的速率ack:表示消息应答的速率
3.6 Admin
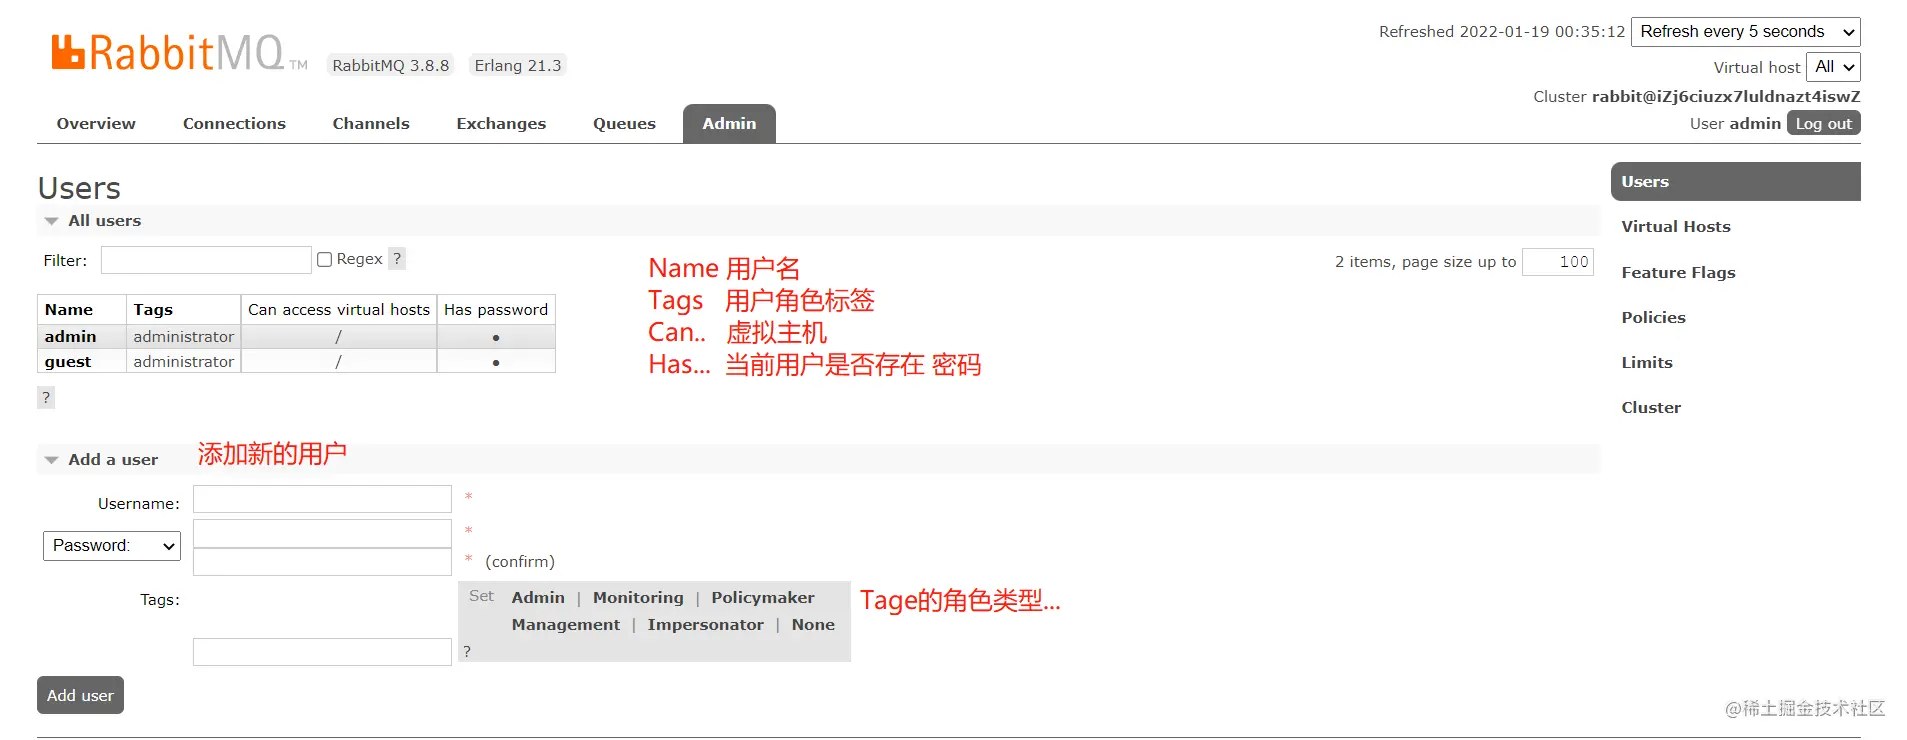
4 基本概念
rabbitmq 的架构图如下: 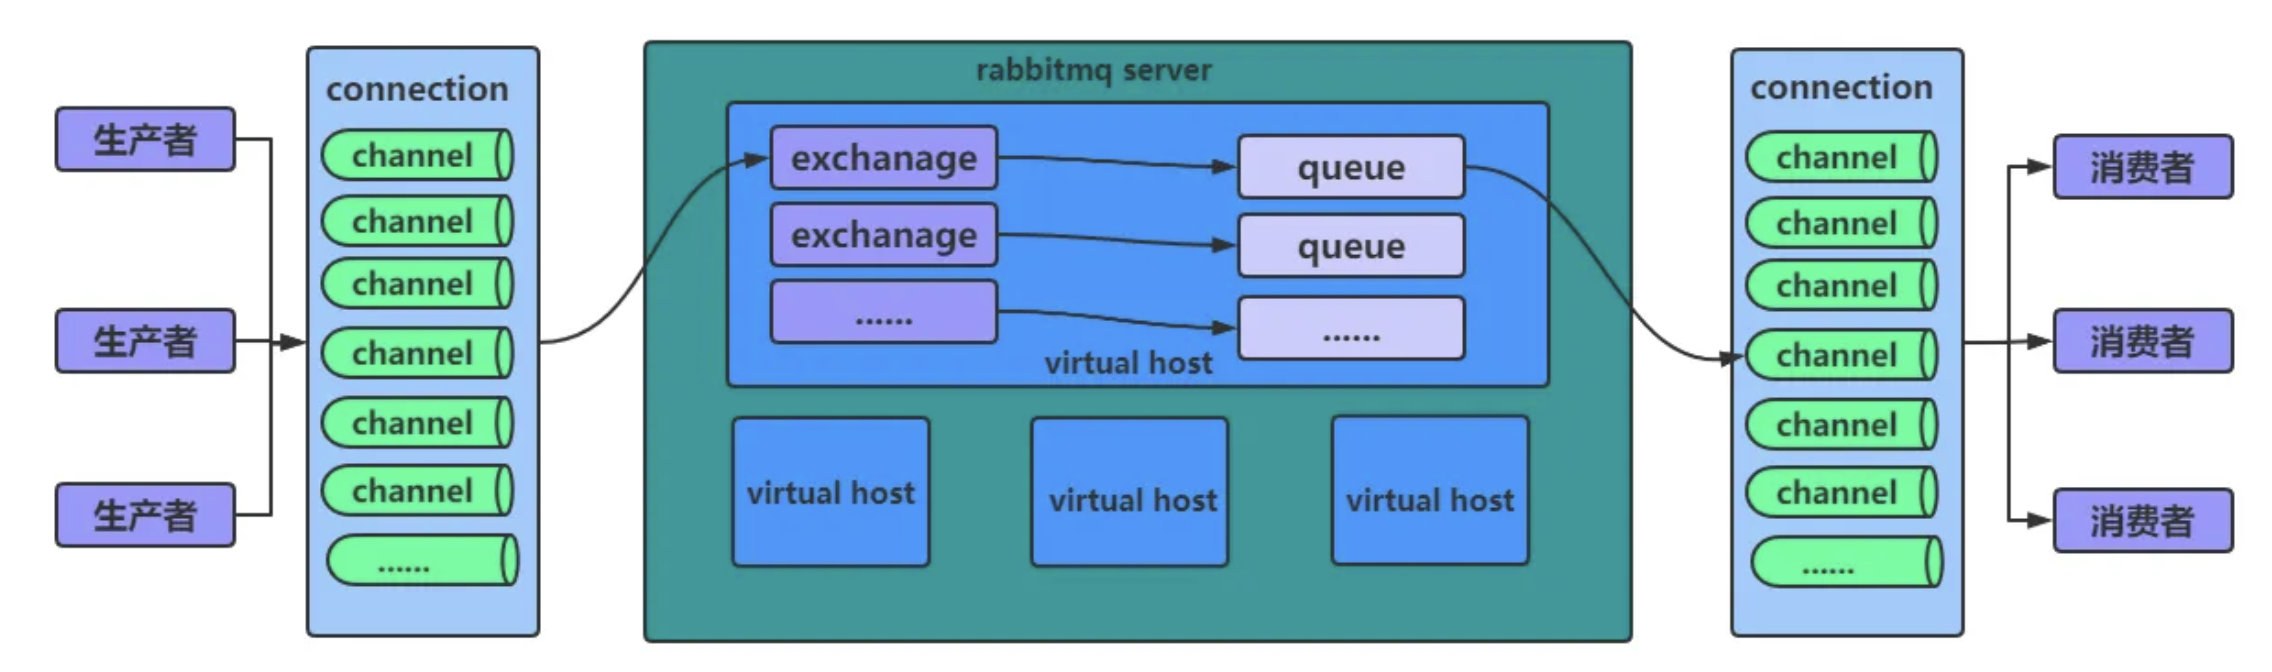 广义上分为:生产者、消费者、消息队列服务
其中生产者、消费者通过 amqp 协议与消息队列服务建立 connection (物理/实际连接),再通过逻辑通信信道 channel 进行生产或消费消息。(这所以这么做,是因为 connection 创建和连接是一个很重的操作,逻辑的 channel 就相对轻量很多。)
消息队列服务中还包含:
Virtual Host:类似多租户环境隔离、不同环境可以配置不同的Virtual Host,每个Virtual Host中的Exchange和Queue互不影响(如可同名)。Exchange:功能为交换机,用于决定将消息转发到实际的Queue中,可以通过Exchange实现多种不同的消息收发模式。(下面会介绍)Queue:消息队列本体Broker:表示 RabbitMQ 服务端
4.1 Exchange 属性概述
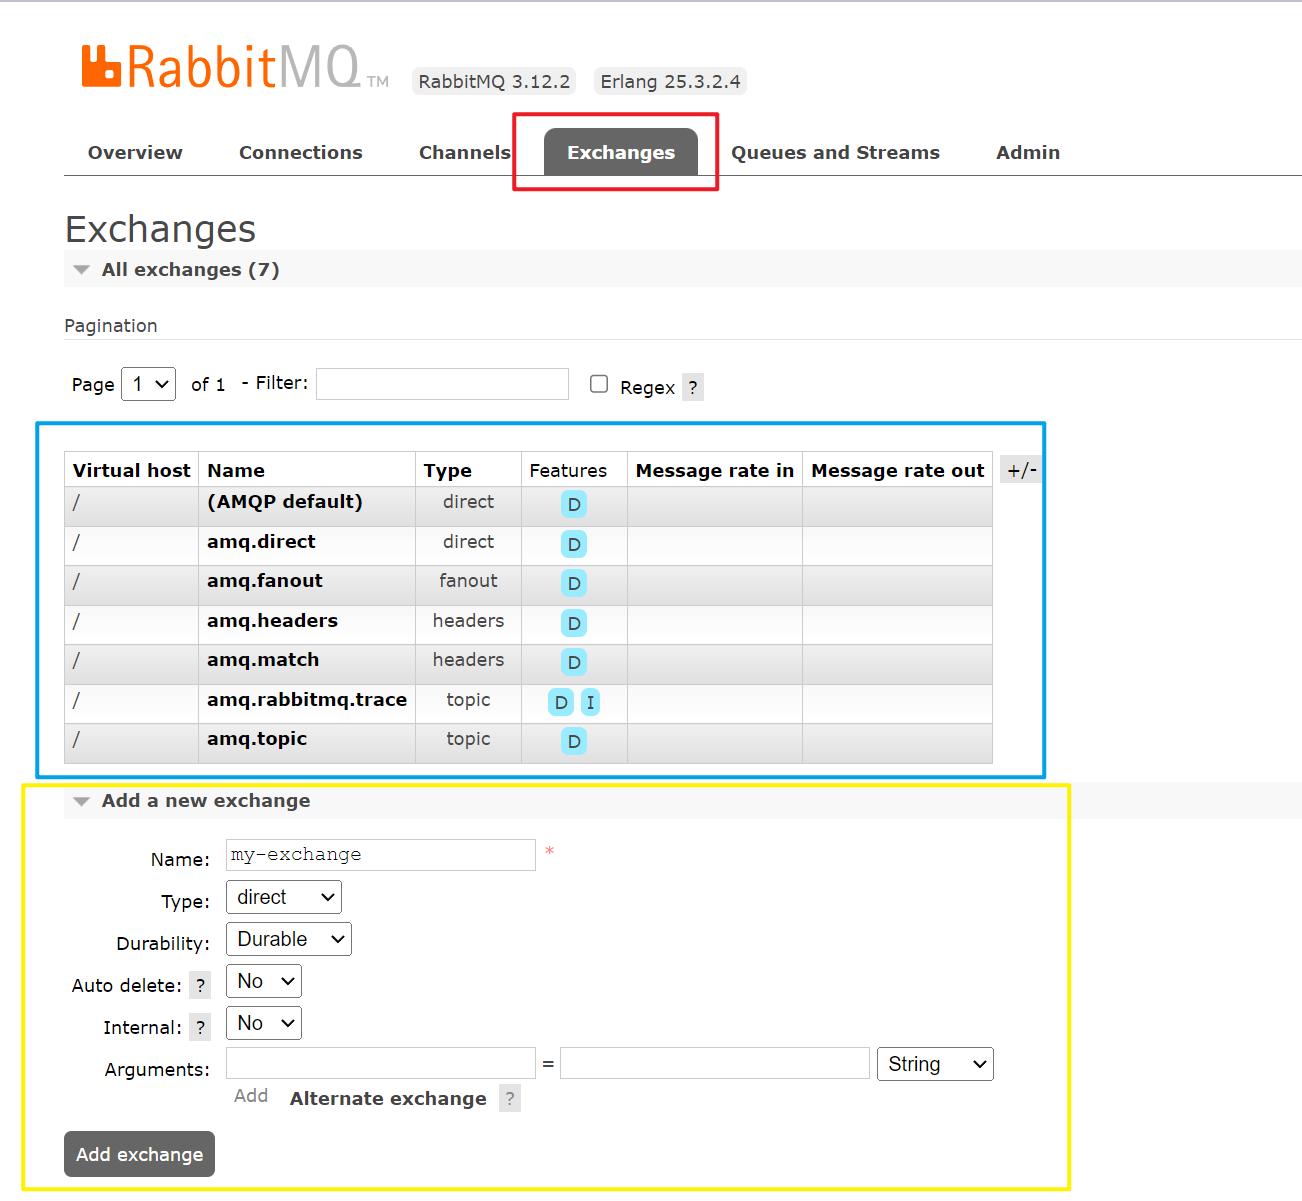 红色圈住的是
Exchange 在网页中的入口。 蓝色圈住的是 Exchange 列表(本图中的都是 rabbitmq 系统默认提供的) 黄色圈住的是创建 Exchange 的参数:
Name:Exchange名称,同一个Virtual Host中不能重复。Type:目前只需要了解 direct,还有 fanout、headers、topic,路由功能不同,后面会一一讲解。Durability:是否需要持久化(如蓝色框中 Features 列标记了一个D,就是当前参数启用的意思)Auto Delete:当有客户端连接后,所有客户端断开与当前Exchange的连接后,是否自动删除该ExchagneIntenal:是否仅用于 rabbitmq 内部使用(可以用于记录 rabbitmq 日志,如蓝色框中的amq.rabbitmq.trace的 Features 中标记了一个I,就是当前参数启用的意思)Arguments:扩展的参数信息,可根据业务需要自定义。
如果系统中有多个
Virtual host,创建Exchange时也会让选择所属Virtual host。
4.2 Queue 属性概述
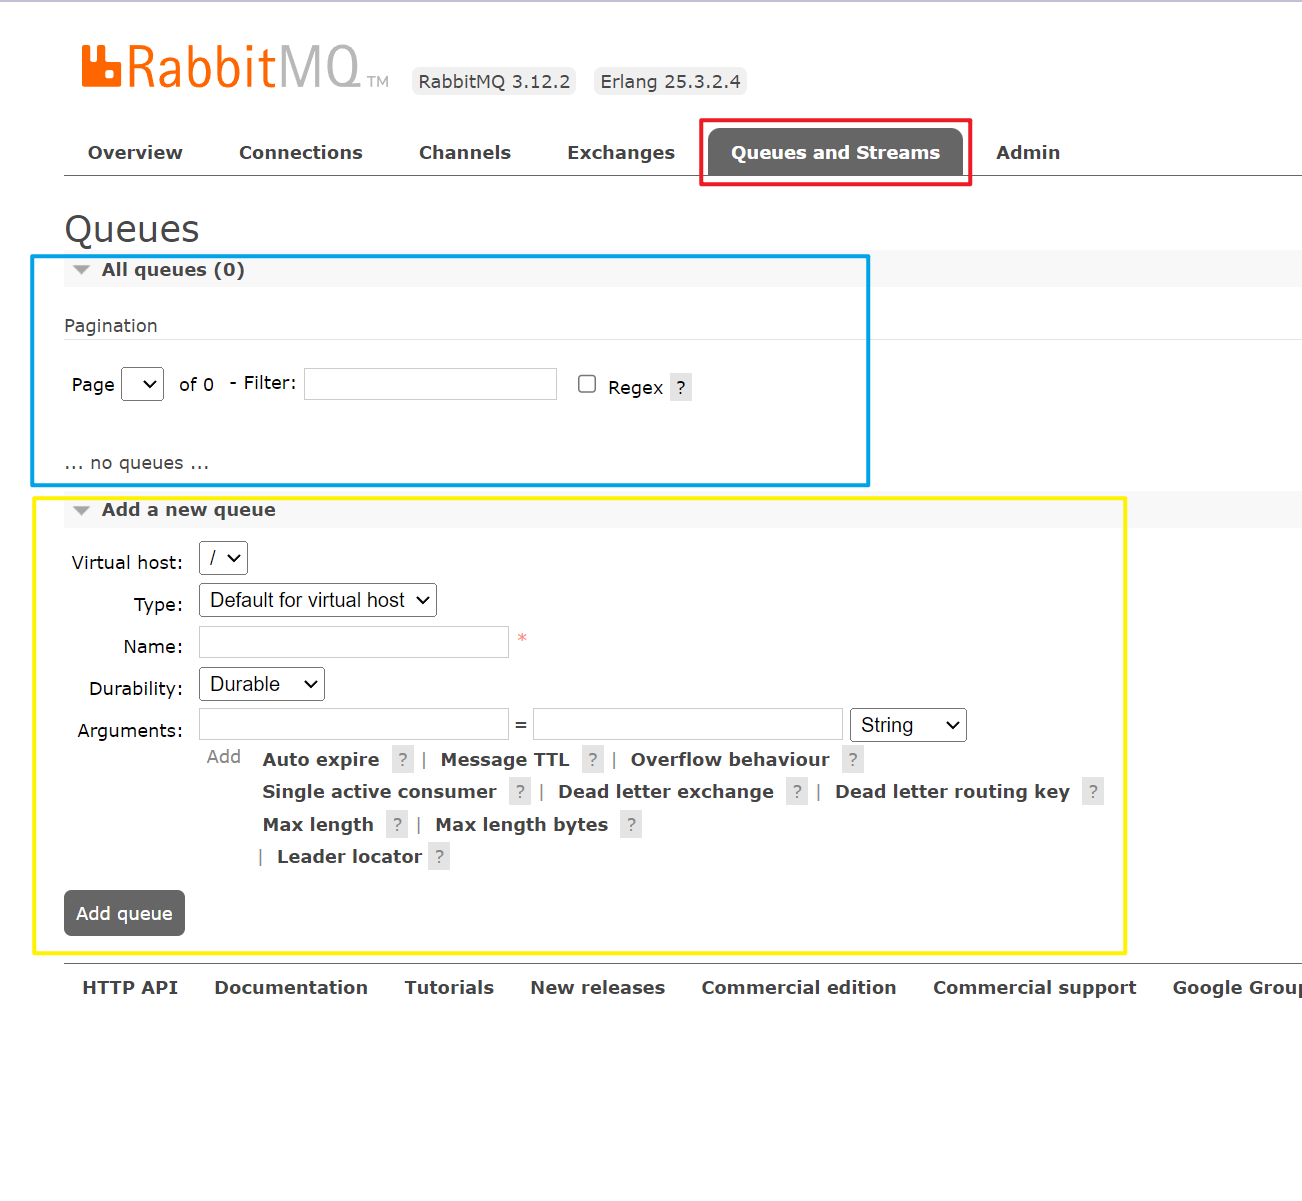 红色圈住的是
Queue 在网页中的入口。 蓝色圈住的是 Queue 列表,默认是什么都没有的。 黄色圈住的是创建 Queue 的参数:
Virtual host:虚拟主机,用来数据隔离。TypeDefault for virtual host:使用创建Virtual host时的默认值。Classic:经典模式的队列Quorum:特点是自动复制,可以在多个节点之间复制消息。Stream:流式队列,面向日志场景,具有高吞吐量,采用追加写入模式。
Name:队列名称Durability:是否持久化Arguments:扩展的参数信息,可根据业务需要自定义。
4.3 Exchange 和 Queue 绑定
现在已添加一个名为 my-exchange 的 Exchange 和一个名为 my-queue 的 Queue,现在尝试绑定两者。如: 
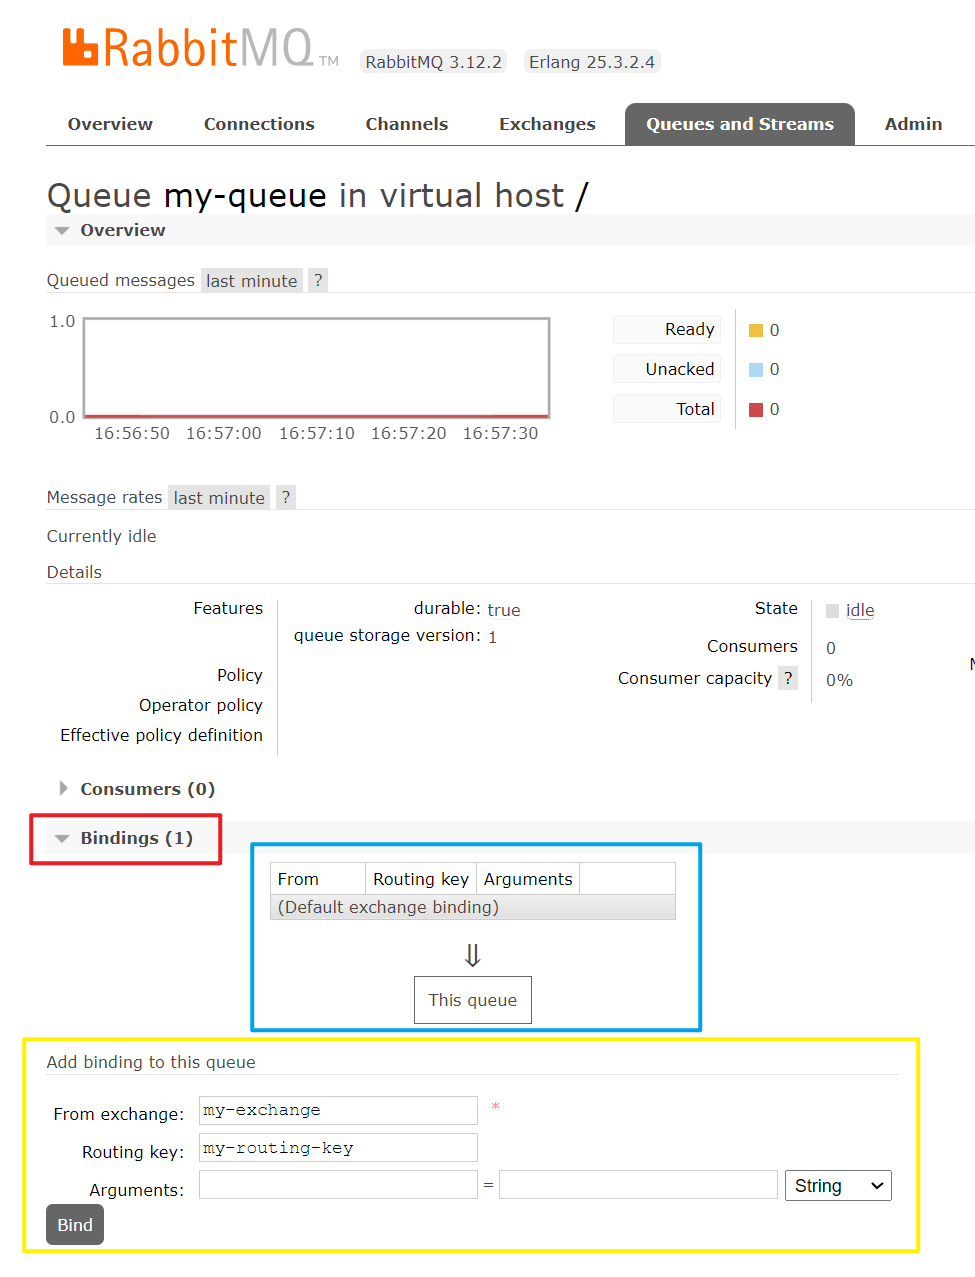
红色框住的是功能入口 蓝色框住的是已经绑定的 exchange,可以看到这里已经有一个默认绑定的,这个就是在 Exchange 页面看到的名为 (AMQP default) 的 exchange。 黄色框住的是绑定所需的参数:
From exchange:要绑定到的Exchange名称Routing key:绑定的路由 key,建议与Exchange同名。后面也可以通过这个 key 来过滤 queue。Arguments:扩展的参数信息,可根据业务需要自定义。
4.4 通过网页端发送消息
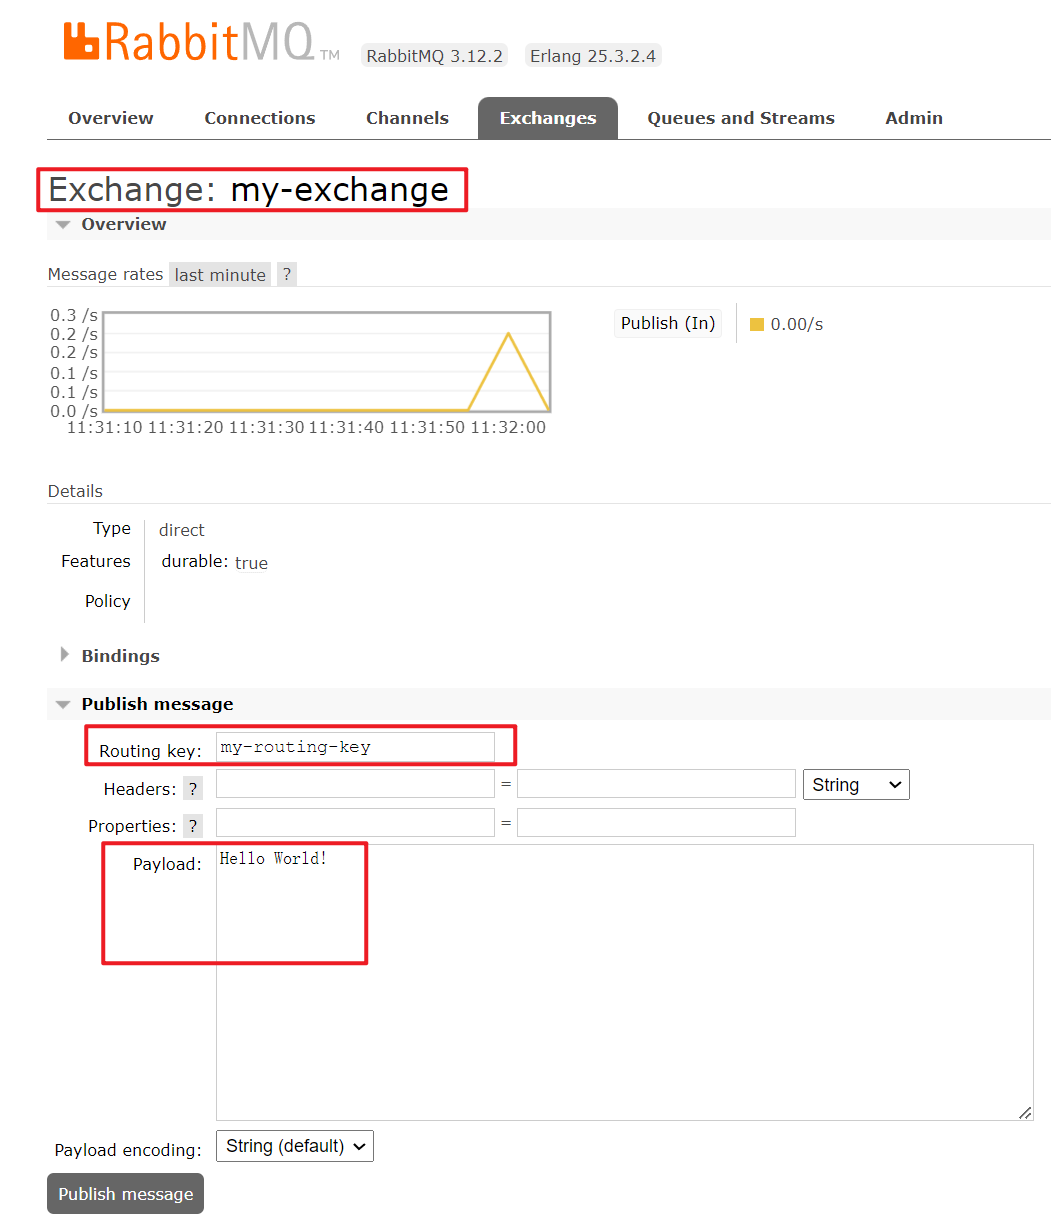
我们在 my-exchange 交换机中发送消息: Routing Key 使用 Exchange 和 Queue 绑定时设置的值。 Payload 要发送的消息正文。
发送成功后会提示:Message published. 如 Routing Key 写错,可能会提示:Message published, but not routed.
4.5 通过网页端接收消息
然后切换到 Queue 标签,可以看到绑定时对应 Routing Key 的队列 my-queue 中有一条消息。 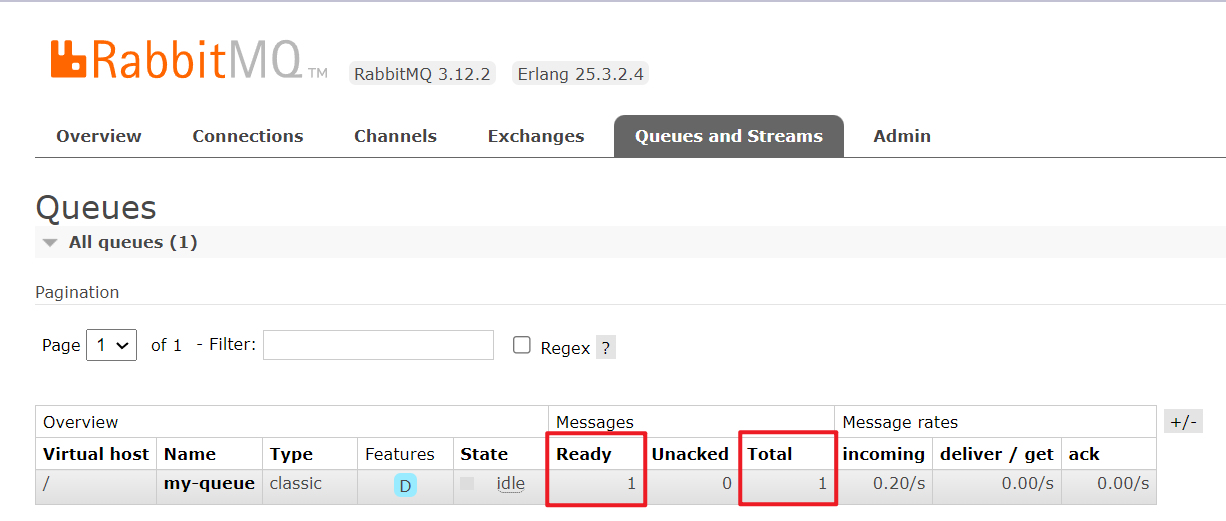
点进去 my-queue 队列详情后,可接收消息: 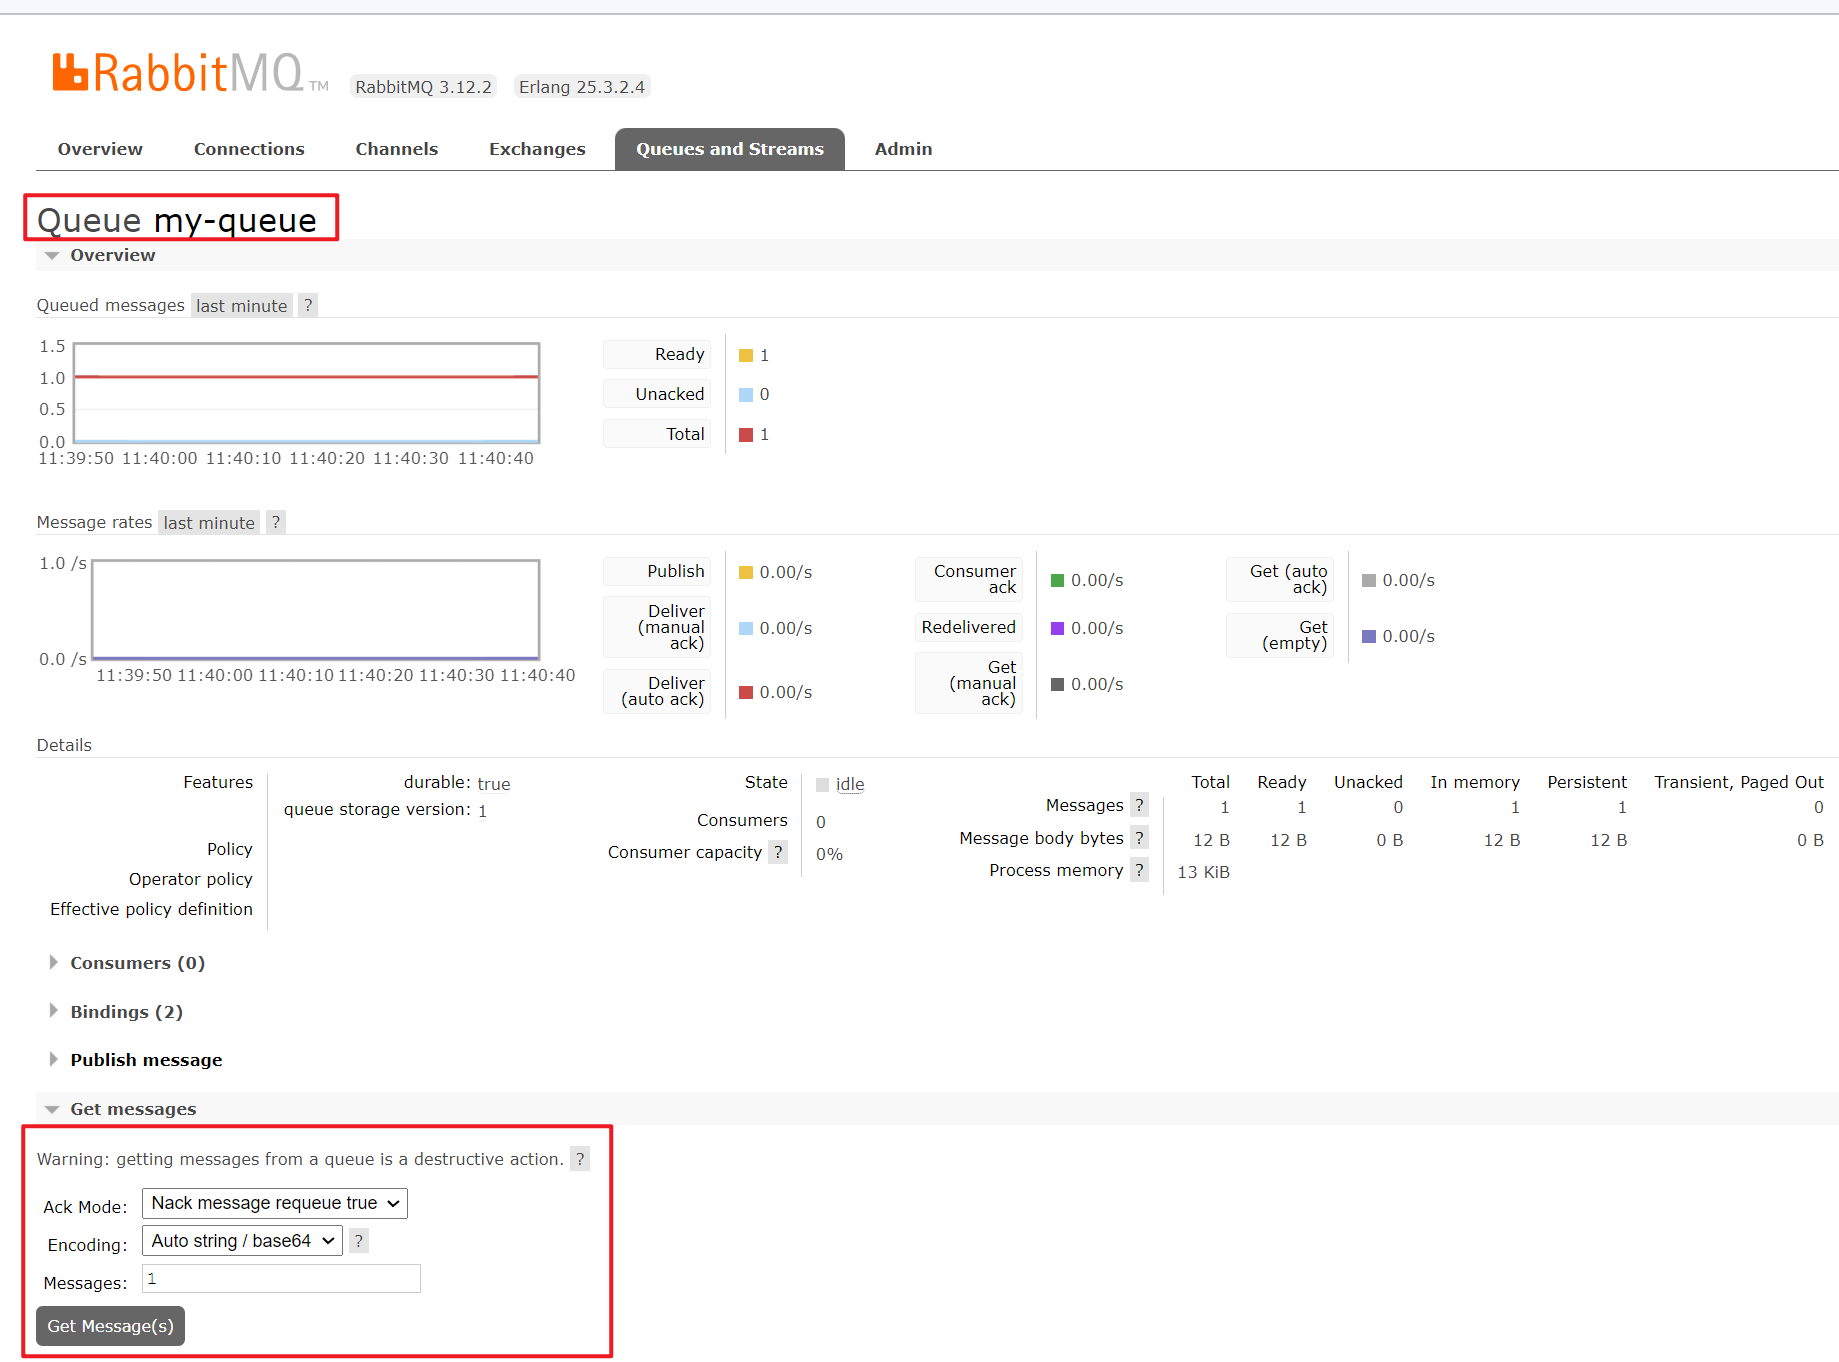
接收消息有三个参数:
Ack Mode:应答模式Nack message request true:获取消息,但不做 ack 应答确认,消息重新入队,可以批量Nack。Automatic ack:获取消息,应答确认,消息不重新入队,将会从队列中删除Reject requeue true:拒绝获取消息,消息重新入队,只能拒绝单条消息。Reject requeue false:拒绝获取消息,消息不重新入队,将会被删除,只能拒绝单条消息。
Encoding:消息编码Auto string / base64:因为可能会传输二进制消息,但二进制消息基本不可读很难在浏览器上显示,如果消息可以被解释成 UTF-8 的字符串,则按照字符串显示,否则将以base64进行编码后显示。base64:读取消息后使用base64格式显示。
Messages:一次从队列获取消息的数量
4.6 通过 Java 声明 Exchange、Queue、Binding
通过 maven 引入依赖
<dependency>
    <groupId>com.rabbitmq</groupId>
    <artifactId>amqp-client</artifactId>
    <version>5.14.2</version>
</dependency>
public static void main(String[] args) throws IOException, TimeoutException {
String queueName = "my-queue";
String exchangeName = "my-exchange";
String routingKey = "my-routing-key";
// 连接信息
ConnectionFactory factory = new ConnectionFactory();
factory.setHost("127.0.0.1");
factory.setPort(5672); // amqp 协议的端口
factory.setUsername("admin");
factory.setPassword("123456");
// 创建连接
try (Connection connection = factory.newConnection()) {
// 创建 channel
Channel channel = connection.createChannel();
// 声明交换机
channel.exchangeDeclare(exchangeName, BuiltinExchangeType.DIRECT, true, false, null);
// 声明队列
channel.queueDeclare(queueName, true, false, false, null);
// 将交换机与队列绑定
channel.queueBind(queueName, exchangeName, routingKey);
} catch (Exception e) {
e.printStackTrace();
}
}其中 exchangeDeclare 方法的参数如下:
exchange:交换机名称type:类型,支持direct、fanout、headers、topicdurable:是否持久化autoDelete:是否自动删除arguments:业务额外参数
其中 queueDeclare 方法的参数如下:
queue:队列的名称durable:是否持久化。exclusive:是否排他,如果一个队列被声明为排他队列,该队列仅对首次声明它的连接可见,并在连接断开时自动删除。排他队列是基于Connection可见,同一个Connection的不同Channel是可以同时访问同一个连接创建的排他队列,并且,如果一个Connection已经声明了一个排他队列,其他的Connection是不允许建立同名的排他队列的,即使该队列是持久化的,一旦Connection关闭或者客户端退出,该排他队列都会自动被删除。autoDelete:是否自动删除。arguments:设置队列的其他一些参数,这里我们暂时不需要什么其他参数。
其中 queueBind 方法参数如下:
queue:需要绑定的队列名称。exchange:需要绑定的交换机名称。routingKey:绑定用的 key。
4.7 通过 Java 发送消息
public static void main(String[] args) throws IOException, TimeoutException {
    String queueName = "my-queue";
    String exchangeName = "my-exchange";
    String routingKey = "my-routing-key";

    // 连接信息
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    // 创建连接
    try (Connection connection = factory.newConnection()) {
        // 创建 channel
        Channel channel = connection.createChannel();
        // 声明交换机
        channel.exchangeDeclare(exchangeName, BuiltinExchangeType.DIRECT, true, false, false,null);
        // 声明队列
        channel.queueDeclare(queueName, true, false, false, null);
        // 将交换机与队列绑定
        channel.queueBind(queueName, exchangeName, routingKey);

        // 向交换机发送消息
        channel.basicPublish(exchangeName, routingKey, null, "Hello World!".getBytes());
    } catch (Exception e) {
        e.printStackTrace();
    }
}
channel.basicPublish 方法用于发送消息,参数如下:
exchange:交换机名称routingKey:路由 keyprops:其他额外的参数配置body:消息体,byte[]类型的
其中 exchange 参数可以写空字符串 "",这样的话,第二个参数 routingKey 字段要写参数为队列名称,这样可以 "直接" 往队列中发送消息 (其实使用的是自带的 (AMQP default) 交换机,他默认与所有队列绑定,无需 routingKey,或者说 routingKey 就是队列名)
public static void main(String[] args) throws IOException, TimeoutException {
    String queueName = "my-queue";

    // 连接信息
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    // 创建连接
    try (Connection connection = factory.newConnection()) {
        // 创建 channel
        Channel channel = connection.createChannel();
        // 声明队列
        channel.queueDeclare(queueName, true, false, false, null);

        // 向交换机发送消息
        channel.basicPublish("", queueName, null, "Hello World!".getBytes());
    } catch (Exception e) {
        e.printStackTrace();
    }
}
4.8 通过 Java 接收消息(被动等待推送)
public static void main(String[] args) throws IOException, TimeoutException {
    String queueName = "my-queue";

    // 连接信息
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    Connection connection = factory.newConnection();
    // 创建 channel
    Channel channel = connection.createChannel();

    // 监听队列的消息
    channel.basicConsume(queueName, false, (consumerTag, message) -> {
        log.info("收到消息: {}", new String(message.getBody()));
        // 手动确认消息
        channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
    }, consumerTag -> {
        log.info("消息消费被中断");
    });
}
channel.basicConsume 方法用于接收消息,参数如下:
queue:队列名称autoAck:是否自动回复 ack 消息,开启为 true 时,只要接收到消息,不论消息处理过程是否有报错,都会返回 ack,消息队列会将消息从队列删除。为 false,则需要程序中手动确认回复 ack 还是 nack、rejectdeliverCallback:消息接收后的回调函数cancelCallback:当消费者取消订阅时进行的函数回调
这只是较为常用的一个方法,channel.basicConsume 还有很多重载方法,最完整的方法中还包含:
- 指定
consumerTag,即消费者的 id,在每个channel中不可重复。 - 指定更多回调:
void handleConsumeOk(String consumerTag):当消费者通过调用channel.basicConsume方法注册时调用。void handleCancelOk(String consumerTag):当显示调用channel.basicCancel方法取消消费者时调用void handleShutdownSignal(String consumerTag, ShutdownSignalException sig):当connection或channel关闭时会调用handleRecoverOk:handleDelivery:上面的deliverCallback实际就是调用的这个方法handleCancel:上面的cancelCallback实际就是调用的这个方法
4.9 通过 Java 接收消息(主动拉取)
除了监听某个队列的消息,等待 Broker 推送过来,还可以主动去拉取某个队列的消息:
GetResponse basicGet(String queue, boolean autoAck) throws IOExcepiton;

// demo:
GetResponse getResponse = channel.basicGet(queueName, false);
if (getResponse != null) {
    channel.basicAck(getResponse.getEnvelope().getDeliveryTag(), false);
}
其中 queue 表示从哪个队列获取消息,autoAck 表示是否自动 ack。不自动 ack 的话需要手动调用 channel.basicAck 进行响应。
虽然可以使用无限循环的方式主动拉取消息来实现和
basicConsume一样的效果,但是不建议这么做。这样会严重影响 RabbitMQ 的性能,如果要实现高吞吐量,还是建议使用basicConsume。
5 工作模式
5.1 基础模式
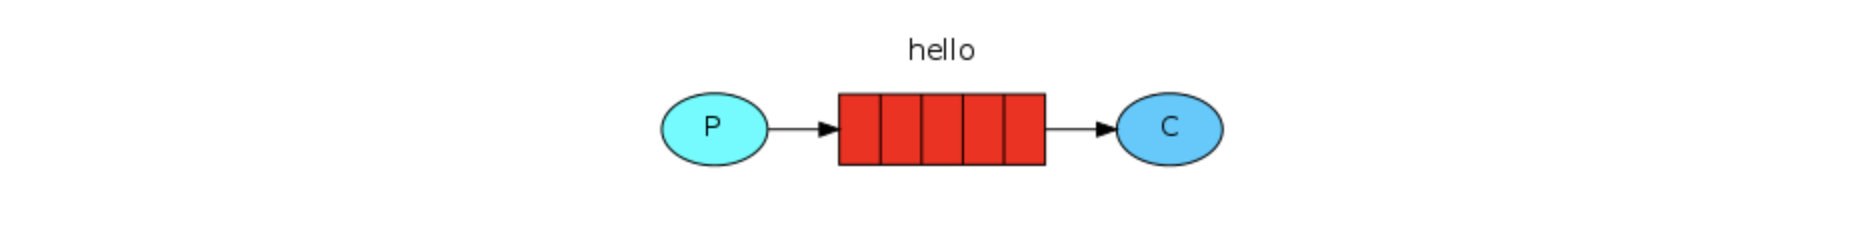
简单说就一个生产者 -> 消息队列 -> 一个消费者。 生产者只需要将消息丢入消息队列,消费者只需要去指定队列中取即可。如本文中的 2.6、2.7、2.8 的内容,就是基础模式。
5.2 工作队列模式 Work Queue 交换机类型:direct (AMQP default)
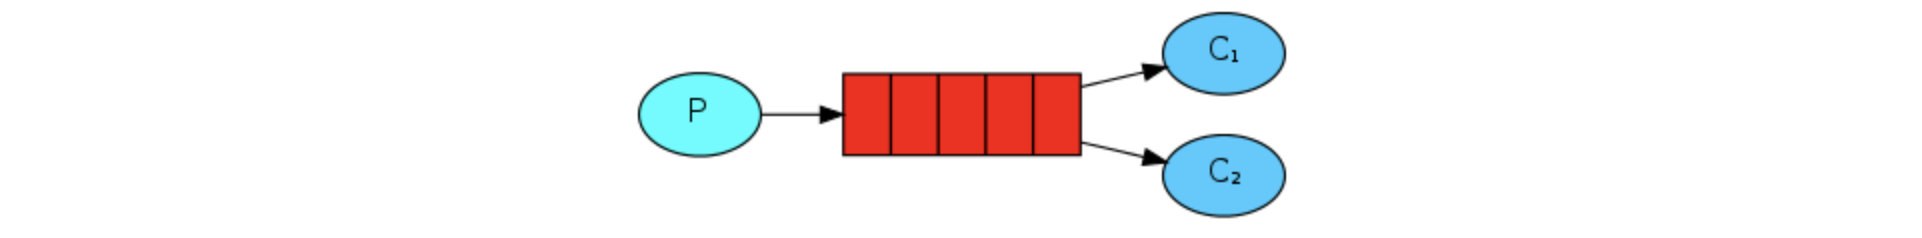 其实就是一个生产者,两个消费者。两个消费者会轮流获取到消息,这里用代码实现如下:
生产者每秒生产一条消息:
public static void main(String[] args) throws IOException, TimeoutException {
    String queueName = "my-queue";

    // 连接信息
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    // 创建连接
    try (Connection connection = factory.newConnection()) {
        // 创建 channel
        Channel channel = connection.createChannel();
        // 声明队列
        channel.queueDeclare(queueName, true, false, false, null);

        int n = 0;
        while (true) {
            // 向交换机发送消息
            channel.basicPublish("", queueName, null, ("Hello World!, " + n).getBytes());
            n++;
            Thread.sleep(1000L);
        }
    } catch (Exception e) {
        e.printStackTrace();
    }
}
两个消费者监听同一个队列的消息:
private static final String queueName = "my-queue";

public static void main(String[] args) throws IOException, TimeoutException {

    // 连接信息
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    Connection connection = factory.newConnection();
    createConsumer(connection, "消费者1");
    createConsumer(connection, "消费者2");
}

public static void createConsumer(Connection connection, String consumerName) throws IOException {
    // 创建 channel
    Channel channel = connection.createChannel();

    // 监听队列的消息
    channel.basicConsume(queueName, false, (consumerTag, message) -> {
        log.info(consumerName + " 收到消息: {}", new String(message.getBody()));
        // 手动确认消息
        channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
    }, consumerTag -> {
        log.info("消息消费被中断");
    });
}
先启动消费者,再启动生产者,然后消费者的控制台可以看到:
15:14:00.878 [pool-1-thread-5] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 0
15:14:01.886 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者2 收到消息: Hello World!, 1
15:14:02.895 [pool-1-thread-7] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 2
15:14:03.904 [pool-1-thread-8] INFO com.mqtest.worker.RabbitReceiveTest - 消费者2 收到消息: Hello World!, 3
15:14:04.914 [pool-1-thread-9] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 4
15:14:05.923 [pool-1-thread-10] INFO com.mqtest.worker.RabbitReceiveTest - 消费者2 收到消息: Hello World!, 5
15:14:06.934 [pool-1-thread-11] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 6
刚才是队列初始时空的,然后先启动的消费者,再启动的生产者,两个消费者会轮流收到消息。
但如果先启动消费者,再启动生产者,这时候队列中已经有一条消息了,这时候对积压的消息还会轮流处理吗?来试试。 我先生产一些消息,然后启动消费者,日志输出如下:
15:19:40.124 [pool-1-thread-4] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 16
15:19:40.129 [pool-1-thread-4] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 17
15:19:40.130 [pool-1-thread-4] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 18
15:19:40.130 [pool-1-thread-4] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 19
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 20
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 21
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 22
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 23
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 24
15:19:40.130 [pool-1-thread-6] INFO com.mqtest.worker.RabbitReceiveTest - 消费者1 收到消息: Hello World!, 25
可以看到,如果一开始就存在消息,会被一个消费者一次性全部消耗,这是因为我们没有设置 Prefetch count(预获取数量,一次性获取消息的最大数量)进行限制,如图可以看到现在是没有限制的。 
5.2.1 拓展:prefetchCount/qos
在 Java 中可以通过以下代码来设置:
channel.basicQos(0, 1, true);参数释义如下:
prefetchSize:最大 unchecked 消息的字节数。prefetchCount:最大 unchecked 消息的条数。0 表示无限制(消息过多可能会导致客户端内存溢出)global:限定范围,true 为整个channel,false 为后续创建的consumer
unchecked表示客户端接收到消息,但未回复 ack 的消息数量。如果unchecked=prefetchCount则服务端将不再发送消息给该消费者,直到unchecked<perfecthCount。
如,一个 channel 中有一个消费者,想让这个消费者,一次最多有 10 条 unchecked 的消息:
Channel channel = ...;
Consumer consumer = ...;
channel.basicQos(10, false); // Per consumer limit
channel.basicConsume("my-queue", false, consumer);
如,一个 channel 中有两个消费者,每个消费者分别一次最多接收 10 条 unchecked 的消息。
Channel channel = ...;
Consumer consumer1 = ...;
Consumer consumer2 = ...;
channel.basicQos(10, false); // Per consumer limit
channel.basicConsume("my-queue1", false, consumer1);
channel.basicConsume("my-queue2", false, consumer2);
如,一个 channel 中有两个消费者,想让每个消费者分别一次最多接收 10 条 unchecked 的消息,但是一共加起来不能超过 15 条 unchecked 消息。
Channel channel = ...;
Consumer consumer1 = ...;
Consumer consumer2 = ...;
channel.basicQos(10, false); // Per consumer limit
channel.basicQos(15, true);  // Per channel limit
channel.basicConsume("my-queue1", false, consumer1);
channel.basicConsume("my-queue2", false, consumer2);
可以理解为 channel 有一个大的容器,里面可以存储 unchecked 消息,channel 中每个 consumer 在这个容器中有一部分自己的空间,但所有 channel 加起来的空间肯定不会超过整个 channel 的空间。
扩展知识: RabbitMQ 的 global 表示的含义和 AMQP 0-9-1 标准协议中定义的不同。 AMQP 0-9-1 中 global 的含义:
true:整个 connection 中所有消费者共享false:整个 channel 中所有消费者共享RabbitMQ中 global 的含义:true:整个 channel 中所有消费者共享false:分别应用于 channel 中每个消费者
参考链接:
- RabbitMQ 官方文档: https://www.rabbitmq.com/consumer-prefetch.html
- RabbitMQ 之 Qos prefetch[简书]: https://www.jianshu.com/p/4d043d3045ca
5.3 发布订阅模式 Publish/Subscribe 交换机类型 fanout
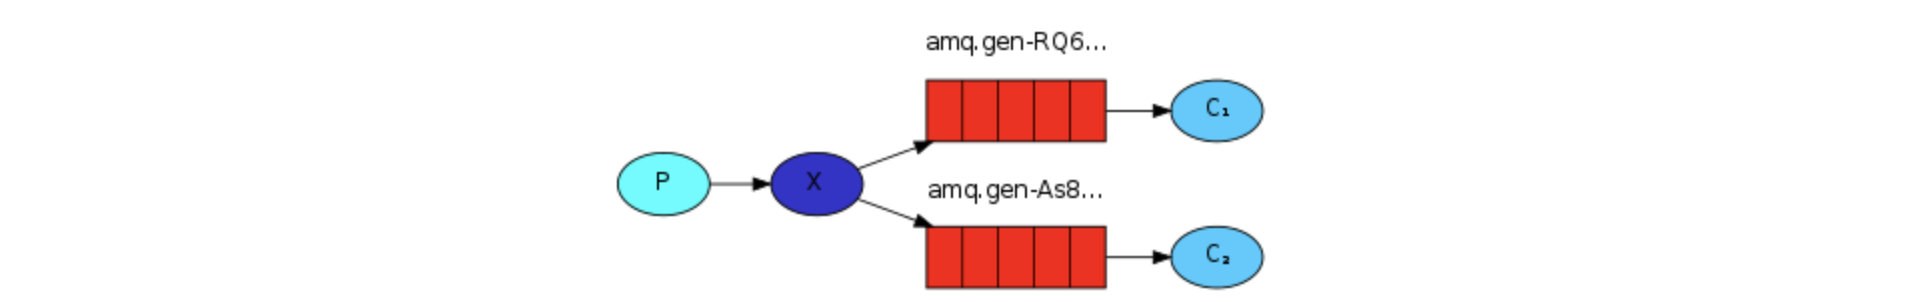 发布订阅模式就是有一个
fanout 类型的交换机,N 个与该交换机绑定的队列。当生产者向这个交换机发送消息时,会向所有绑定的队列都发送消息(而不是工作队列模式 direct 类型的交换机时,消费者轮流消费)。
创建一个 fanout 类型的 exchange,并将两个队列绑定到该 exchange,然后发送一条消息:
public static void main(String[] args) throws IOException, TimeoutException {
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    Connection connection = factory.newConnection();
    Channel channel = connection.createChannel();


    // 创建一个 fanout 类型的交换机
    String exchangeName = "my-fanout-exchange";
    channel.exchangeDeclare(exchangeName, BuiltinExchangeType.FANOUT, true, false, null);

    // 创建两个队列,绑定到交换机上,无需指定 routingKey    String queueName1 = "queue-one";
    String queueName2 = "queue-two";
    channel.queueDeclare(queueName1, true, false, false, null);
    channel.queueDeclare(queueName2, true, false, false, null);
    channel.queueBind(queueName1, exchangeName, "");
    channel.queueBind(queueName2, exchangeName, "");

    // 向交换机发送消息
    channel.basicPublish(exchangeName, "", null, "fanout 消息".getBytes());
}
当队列与 fanout 类型的 exchange 绑定时,routingKey 可以写空字符串,或者写任意字符都可以,都不影响 fanout 的功能。
然后创建两个消费者,去获取这两个绑定到 fanout 的队列中的消息:
public static void main(String[] args) throws IOException, TimeoutException {
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    Connection connection = factory.newConnection();
    Channel channel = connection.createChannel();

    // 创建一个 fanout 类型的交换机
    String exchangeName = "my-fanout-exchange";
    channel.exchangeDeclare(exchangeName, BuiltinExchangeType.FANOUT, true, false, null);

    // 创建两个队列,绑定到交换机上,无需指定 routingKey    String queueName1 = "queue-one";
    String queueName2 = "queue-two";
    channel.queueDeclare(queueName1, true, false, false, null);
    channel.queueDeclare(queueName2, true, false, false, null);
    channel.queueBind(queueName1, exchangeName, "");
    channel.queueBind(queueName2, exchangeName, "");

    channel.basicConsume(queueName1, true, (consumerTag, message) -> {
        log.info("消费者1收到消息: {}", new String(message.getBody()));
    }, consumerTag -> {});

    channel.basicConsume(queueName2, true, (consumerTag, message) -> {
        log.info("消费者2收到消息: {}", new String(message.getBody()));
    }, consumerTag -> {});
}
日志输出为:
13:45:49.999 [pool-1-thread-4] INFO com.mqtest.fanout.RabbitMQFanoutReceive - 消费者1收到消息: fanout 消息
13:45:50.004 [pool-1-thread-5] INFO com.mqtest.fanout.RabbitMQFanoutReceive - 消费者2收到消息: fanout 消息
可以看到两个队列都收到了这个消息,这就是 fanout 模式。
5.4 路由模式 Routing 交换机类型:direct
这里和 3.2 工作队列模式很像, 只不过当时没有额外声明 exchange,routingKey 使用的是空字符串,这样会使用 RabbitMQ 自带的 (AMQP default),路由模式就是使用 routingkey 将队列绑定到指定交换机,然后发送消息时,exchange 会根据 routingKey 转发到指定的队列中。
如一个自定义 exchange,创建两个队列分别使用不同的 routingKey 绑定,然后分别向这两个 routingKey 发送不同的消息:
public static void main(String[] args) throws IOException, TimeoutException {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("127.0.0.1");
        factory.setPort(5672);
        factory.setUsername("admin");
        factory.setPassword("123456");

        Connection connection = factory.newConnection();
        Channel channel = connection.createChannel();

        // 创建一个 direct 类型的交换机
        String exchangeName = "my-routing-exchange";
        channel.exchangeDeclare(exchangeName, BuiltinExchangeType.DIRECT, true, false, null);

        // 创建两个队列,绑定到交换机上,无需指定 routingKey
        String queueName1 = "queue-one";
        String queueName2 = "queue-two";
        String routingKey1 = "routing-key-1";
        String routingKey2 = "routing-key-2";

        channel.queueDeclare(queueName1, true, false, false, null);
        channel.queueDeclare(queueName2, true, false, false, null);
        channel.queueBind(queueName1, exchangeName, routingKey1);
        channel.queueBind(queueName2, exchangeName, routingKey2);

        // 向交换机发送消息
        channel.basicPublish(exchangeName, routingKey1, null, "routingKey1 message".getBytes());
        channel.basicPublish(exchangeName, routingKey2, null, "routingKey2 message".getBytes());
    }
在创建两个消费者,分别取获取这两个队列的消息:
public static void main(String[] args) throws IOException, TimeoutException {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("127.0.0.1");
        factory.setPort(5672);
        factory.setUsername("admin");
        factory.setPassword("123456");

        Connection connection = factory.newConnection();
        Channel channel = connection.createChannel();

        // 创建一个 direct 类型的交换机
        String exchangeName = "my-routing-exchange";
        channel.exchangeDeclare(exchangeName, BuiltinExchangeType.DIRECT, true, false, null);

        // 创建两个队列,绑定到交换机上,无需指定 routingKey
        String queueName1 = "queue-one";
        String queueName2 = "queue-two";
        String routingKey1 = "routing-key-1";
        String routingKey2 = "routing-key-2";

        channel.queueDeclare(queueName1, true, false, false, null);
        channel.queueDeclare(queueName2, true, false, false, null);
        channel.queueBind(queueName1, exchangeName, routingKey1);
        channel.queueBind(queueName2, exchangeName, routingKey2);

        channel.basicConsume(queueName1, true, (consumerTag, message) -> {
            log.info("从队列 {} 中收到消息: {}", queueName1, new String(message.getBody()));
        }, consumerTag -> {});

        channel.basicConsume(queueName2, true, (consumerTag, message) -> {
            log.info("从队列 {} 中收到消息: {}", queueName2, new String(message.getBody()));
        }, consumerTag -> {});
    }
然后日志输出为:
14:07:32.459 [pool-1-thread-4] INFO com.mqtest.routing.RabbitMQRoutingReceive - 从队列 queue-one 中收到消息: routingKey1 message
14:07:32.464 [pool-1-thread-5] INFO com.mqtest.routing.RabbitMQRoutingReceive - 从队列 queue-two 中收到消息: routingKey2 message
可以看到 exchange 通过 routingKey 分别发送到了对应的队列中。
5.5 主题模式 Topic 交换机类型 topic
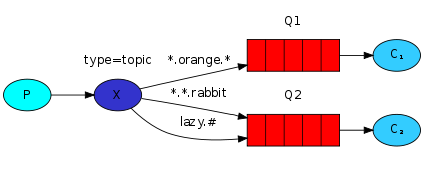 topic 类型实际上是一种模糊匹配的模式,可以在和
exchange 绑定时的 routingKey 上使用通配符:
#:表示 0 个或多个单词*:表示 1 个单词
如队列对交换机绑定时以下两种情况:
- 使用的
routingKey为a.#,那么发送消息时,指定routingKey为a、a.a、a.b、a.b.c、a.b.c.d.e都可以发送到对应的队列中,但b.c、b这种不行。 - 使用的
routingKey为a.*,那么发送消息时,指定routingKey为a.a、a.b可以发送到对应的队列中,但a、b.c、b这种不行。
5.6 头部模式 Header 交换机类型 headers
RabbitMQ 的消息也可以有消息头,有点像 HTTP 协议。headers 类型的交换机不再使用 routingKey 来路由消息,而是在与队列绑定时的 arguments 中添加匹配规则和匹配的消息头,然后发送消息时携带消息头,交换机会根据绑定时 arguments 的信息来判断发给哪个队列。
如,绑定关系时:
// 创建一个 headers 类型的交换机
String exchangeName = "my-headers-exchange";
channel.exchangeDeclare(exchangeName, BuiltinExchangeType.HEADERS, true, false, null);

// 创建队列
String queueName1 = "headers-queue";
channel.queueDeclare(queueName1, true, false, false, null);

// 声明绑定关系用到的 header 匹配规则和数据
Map<String, Object> header = new HashMap<>();
header.put("x-match", "all");  //x-match: all 表所有 key-value 全部匹配才匹配成功 ,any 表只需要匹配任意一个 key-value 即匹配成功。
header.put("age", "10");
header.put("size", "20");

// 将交换机与队列绑定,routingKey 留空,但增加 header 参数
channel.queueBind(queueName1, exchangeName, "", header);
需要注意的时,headers 类型的交换机有两种匹配模式,一种是 all 一种是 any,分别表示 header 全部匹配和任意匹配其中一个的情况。
发送消息时:
// 构建发送消息时的 header
Map<String, Object> header = new HashMap<>();
header.put("age", "10");
header.put("size", "20");
header.put("name", "zhangsan");

AMQP.BasicProperties.Builder properties = new AMQP.BasicProperties().builder().headers(header);

// 向交换机发送消息,携带上 header
channel.basicPublish(exchangeName, "", properties.build(), "header 消息".getBytes());
注意: 多出来的 header 不影响 all 匹配模式,只要 bind 时指定的 header 全部匹配即可。
headers模式性能比较差,不推荐使用。
5.7 死信队列 DLX
先说说什么是死信,正常情况,producer 生产消息,消费者从 queue 获取消息。但是有些时候出现一些特定的原因导致 queue 中的消息无法被正常消费,就称之为死信消息,具体有以下几种情况:
- 消息被消费者拒绝 (通过
basic.reject或者basic.nack),且 requeue = false。 - 消息过期,因为队列或者消息设置了 TTL 时间。
- 队列的
x-message-ttl参数可设置消息的过期时间,单位:毫秒。 - 发送消息时,可通过指定
properties的expiration值设置该消息的过期时间,单位:毫秒。
- 队列的
- 消息因超出队列长度限制被丢弃
- 队列的
x-max-length参数可设置队列最大长度,超出后会从队头开始删除消息。 - 队列的
x-max-length-bytes参数可设置队列所有消息最大存储的字节数,超出后会从队头开始删除消息。
- 队列的
如实际业务场景:用户下订单,订单 30 分钟超时,如果 30 分钟内支付成功,则进行后续的扣减库存、发货、邮件/短信通知等业务。如果 30 分钟内没有支付,则认为订单失效,但不能直接删除订单,也要记录下来。
那么就可以在用户下单后将消息发送到待支付队列,然后设置消息超时时间为 30 分钟,并为这个队列设置一个死信队列,这样消息超时未处理就会自动转发到绑定的死信队列中。
或者准确的说,绑定的是死信交换机,一个对象在创建时可以增加参数,x-dead-letter-exchange 和 x-dead-letter-routing-key,前者是死信时转发到的交换机,后者是转发时指定的 routing-key,最终目的地是 routing-key 对应的队列,所以也可以称之为死信队列。
下面给出代码示例: 先声明普通队列和死信队列:
// 正常队列和交换机
String normalQueueName = "normal-queue";
String normalExchangeName = "normal-exchange";
String normalRoutingKey = "normal-routing-key";

// 死信队列和交换机
String deadQueueName = "dead-queue";
String deadExchangeName = "dead-exchange";
String deadRoutingKey = "dead-routing-key";

// 声明普通和死信交换机
channel.exchangeDeclare(normalExchangeName, BuiltinExchangeType.DIRECT, true, false, null);
channel.exchangeDeclare(deadExchangeName, BuiltinExchangeType.DIRECT, true, false, null);

// 声明死信队列并绑定死信交换机
channel.queueDeclare(deadQueueName, true, false, false, null);
channel.queueBind(deadQueueName, deadExchangeName, deadRoutingKey);

// 声明死信队列的参数
HashMap<String, Object> params = new HashMap<>();
params.put("x-dead-letter-exchange", deadExchangeName);
params.put("x-dead-letter-routing-key", deadRoutingKey);

// 声明正常队列并设置对应的死信队列参数,然后绑定正常交换机
channel.queueDeclare(normalQueueName, true, false, false, params);  // 重点是这里的 params
channel.queueBind(normalQueueName, normalExchangeName, normalRoutingKey);
然后发送带超时时间的消息:
AMQP.BasicProperties properties = new AMQP.BasicProperties().builder().expiration("10000").build();
channel.basicPublish(normalExchangeName, normalRoutingKey, properties, "Hello World!".getBytes());
然后就可以去 rabbitmq 控制台查看,normal-queue 队列有一条 Ready 状态的消息,10 秒后就没了,到 dead-queue 队列中了。
5.8 仲裁队列
https://support.huaweicloud.com/intl/zh-cn/usermanual-rabbitmq/rabbitmq_ug_0016.html
5.9 延迟队列
延迟队列有多种实现方式:
- 插件方式
- 死信队列 + 队列/消息 TTL
5.9.1 插件方式延迟队列
需要先去下载插件: https://github.com/rabbitmq/rabbitmq-delayed-message-exchange/releases/ ,如我下载时最新为 v3.12.0,文件名为:rabbitmq_delayed_message_exchange-3.12.0.ez
然后复制到 RabbitMQ 插件目录下:
docker cp ./rabbitmq_delayed_message_exchange-3.12.0.ez rabbitmq-container-name:/plugins然后:
docker exec rabbitmq-container-name rabbitmq-plugins enable rabbitmq_delayed_message_exchange上面两个命令中的 rabbitmq-container-name 为 docker 容器的名称。需要替换为你自己实际的。
启用成功后会返回:
Enabling plugins on node rabbit@9edb04dcd1cd:
rabbitmq_delayed_message_exchange
The following plugins have been configured:
  rabbitmq_delayed_message_exchange
  rabbitmq_management
  rabbitmq_management_agent
  rabbitmq_prometheus
  rabbitmq_web_dispatch
Applying plugin configuration to rabbit@9edb04dcd1cd...
Plugin configuration unchanged.
启用插件后,可以在创建交换机时,type 写 x-delayed-message,交换机的原始类型通过参数 x-delayed-type 指定,如指定为 direct / fanout / headers / topic。然后发送消息时,指定参数 x-delay 值 (毫秒)来设置消息的延迟时间。
5.9.2 死信队列 + TTL (Time To Live)延迟队列
如有两个交换机 E1、E2。两个队列 Q1、Q2。然后将 E1 与 Q1 绑定,E2 与 Q2 绑定。再将 E2 作为 E1 的死信交换机。
然后消息向 E1 发送时,消息中设置 TTL 过期时间,到期后会自动发送给对应的死信队列。这样监听 Q2 的消费者就会延迟收到消息。 (除了发送消息时设置 TTL 过期时间,也可以给 Q1 队列设置 TTL 过期时间,如果两个同时设置,以较小的值为准。)
5.10 优先级队列
RabbitMQ 3.5.0 版本开始支持了优先级队列,使用方法为:
- 创建队列时,在
arguments中设置x-max-priority,值为队列允许设置的最大优先级,只支持在1-255之间设置(默认为 0),优先级越高,越先被消费,且允许的最大值越大,对性能消耗越高! - 发送消息时,在
properties中设置priority,值为消息的优先级,值越大,优先级越高。(如果队列没有设置x-max-priority,则消息的priority也无效)
使用时也有一些注意事项:
- 如果消息的
priority大于x-max-priority,那么消息的优先级会被认为是x-max-priority。如x-max-priority=10,那么发送消息时指定priority=100和priority=200都会被认为是10,不过从消息的properties上看还是原值。 - 对于设置了最大长度(
x-max-length)的队列,当队列满时,也和普通队列一样会从队头开始删除元素,但优先级队列中,高优先级的在队头,这就导致会删除高优先级的消息。 - 当在优先级队列中使用消息自动过期,可能会因为优先级的问题,导致低优先级的消息在未被消费时就已经过期,但仍占用了存储空间,直到消息投递到消费者前检测过期后删除。
- 如果消息立刻被消费了,那么优先级无效。仅当消息积压时,才会按照优先级进行排序。
5.11 RPC 调用
RPC 是 Remote Procedure Call 的简称,可以通过网络来远程调用方法。 如有 A 和 B 两台机器,A 想调用 B 中的一个方法,就可以使用 RPC 的方式来调用,这样两个服务甚至可以是不同语言的,只要都通过 AMQP 协议通信即可。
RabbitMQ 的实现方式是:RPC 客户端发送消息到 RPC 队列 时在消息属性中指定一个参数 replyTo,用于表示接收返回结果的队列,RPC 服务端接收到消息后,将调用方法的返回结果发送到消息属性中指定的 replyTo 队列中,然后 RPC 客户端监听这个队列即可取到返回结果。但是有可能这个队列有多条消息,不知道结果和哪一条 RPC 调用消息相对应,所以 RabbitMQ 在消息中还提供了个 correlationId 属性,用来唯一标记一条消息。 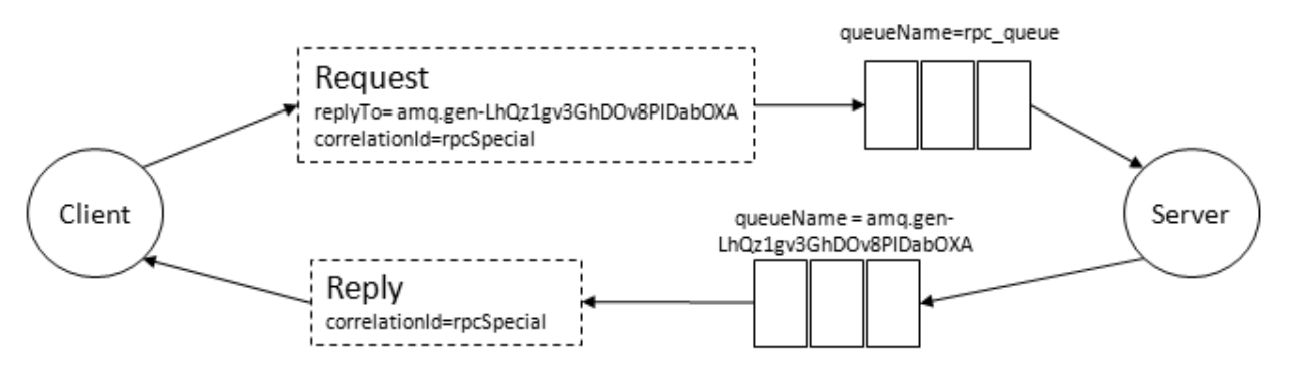 下面有一个例子,A 服务调用 B 服务的
add(Integer a, Integer b) 方法来计算两个数相加的结果:
A 服务 (RPC 客户端):
import com.rabbitmq.client.AMQP;
import com.rabbitmq.client.Channel;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.util.Objects;
import java.util.UUID;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;

@Slf4j
public class RpcClient {

    private static final String RPC_QUEUE = "rpc_queue";

    private static Channel channel;

    public static void main(String[] args) throws IOException, ExecutionException, InterruptedException {
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("127.0.0.1");
        factory.setPort(5672);
        factory.setUsername("admin");
        factory.setPassword("123456");

        Connection connection = factory.newConnection();
        Channel channel = connection.createChannel();

        for (int i = 0; i < 10; i++) {
            Integer callResult = call(i, i);
            log.info("调用远程 rpc 方法, 参数为 ({}, {}),结果:{}", i, i, callResult);
        }
    }

    public static Integer call(Integer a, Integer b) throws IOException, ExecutionException, InterruptedException {
        // 让 RabbitMQ 为我们生成一个随机的队列名称
        String replyQueueName = channel.queueDeclare().getQueue();
        // 生成一个随机的字符串作为 correlationId 值
        String correlationId = UUID.randomUUID().toString();

        AMQP.BasicProperties basicProperties = new AMQP.BasicProperties.Builder()
                .replyTo(replyQueueName)
                .correlationId(correlationId)
                .build();

        // 发送消息到 rpc 服务端队列
        String message = a + "+" + b;
        channel.basicPublish("", RPC_QUEUE, basicProperties, message.getBytes(StandardCharsets.UTF_8));

        // 等待 rpc 响应,使用 future 来存储响应结果
        final CompletableFuture<String> response = new CompletableFuture<>();

        // 消费 rpc 响应队列
        String ctag = channel.basicConsume(replyQueueName, true, (consumerTag, message1) -> {
            if (Objects.equals(message1.getProperties().getCorrelationId(), correlationId)) {
                response.complete(new String(message1.getBody(), StandardCharsets.UTF_8));
            }
        }, consumerTag -> {
        });

        // 返回结果
        String result = response.get();
        // 取消对随机队列的监听
        channel.basicCancel(ctag);
        // 返回结果
        return Integer.valueOf(result);
    }

}
import com.rabbitmq.utils.RabbitMQUtils;
import com.rabbitmq.client.AMQP;
import com.rabbitmq.client.Channel;
import java.io.IOException;
public class RpcServer {
private static final String RPC_QUEUE = "rpc_queue";
private static Channel channel;
public static void main(String[] args) throws IOException {
ConnectionFactory factory = new ConnectionFactory();
factory.setHost("127.0.0.1");
factory.setPort(5672);
factory.setUsername("admin");
factory.setPassword("123456");
Connection connection = factory.newConnection();
Channel channel = connection.createChannel();
channel.queueDeclare(RPC_QUEUE, false, false, false, null);
channel.basicConsume(RPC_QUEUE, false, (consumerTag, message) -> {
String msg = new String(message.getBody());
String[] split = msg.split("\\+");
Integer a = Integer.parseInt(split[0]);
Integer b = Integer.parseInt(split[1]);
String result = String.valueOf(add(a, b));
AMQP.BasicProperties basicProperties = new AMQP.BasicProperties.Builder()
.correlationId(message.getProperties().getCorrelationId())
.build();
String replyToQueue = message.getProperties().getReplyTo();
channel.basicPublish("", replyToQueue, basicProperties, result.getBytes());
channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
}, consumerTag -> {
});
}
public static Integer add(Integer a, Integer b) {
return a + b;
}
}6 其他细节
6.1 消息确认接收机制 ACK
为什么需要消息确认机制,试想下,消费者从队列中取到一个消息,要去处理,但是处理消息的过程中出现了异常,那么这条消息应该如何处理,RabbitMQ 是否知道消息消费的过程中出现了异常,这条消息要不要被认为正常处理完进行删除。 因此 RabbitMQ 有一个 ACK 机制,当消费者收到消息后,要向 RabbitMQ 服务端发送回执 ACK,告知消息处理情况,支持以下两种 ACK 方式:
- 自动 ACK:消费者从队列中取出消息后,就自动给服务端发送一个 ACK 成功的回执。表示消息消费成功,然后消息将会从消息队列中被删除。
- 手动 ACK:消费者从队列中取出消息后,根据处理情况手动进行 ACK 回执,告诉是否消费成功。
自动 ACK: 在监听队列消息时有参数设置是否自动 ACK,这种模式优点是吞吐量高,避免队列中挤压过多的未 ACK 消息,但是可能存在消费者处理异常后消息丢失的问题。
手动 ACK: 接收消息后手动调用代码进行处理: void basicAck(long deliveryTag, boolean multiple); 用于表示确认收到消息,参数释义如下:
long deliverTag:表示消息的唯一标识符。boolean multiple:表示是否批量处理,如果设置为 true,则表示确认所有该消息之前的所有消息。void basicReject(long deliveryTag, boolean requeue);表示拒绝消息,参数释义如下:long deliverTag:表示消息的唯一标识符。boolean requeue:表示是否将消息重新入队。void basicNack(long deliveryTag, boolean multiple, boolean requeue);同样用于表示拒绝消息,但多了一个参数multiple,参数释义如下:long deliverTag:表示消息的唯一标识符。boolean multiple:表示是否批量处理,如果设置为 true,则表示确认所有该消息之前的所有消息。boolean requeue:表示是否将消息重新入队。
可能你会疑惑,为什么有两个拒绝消息的 API,这两个除了多一个参数外还有什么区别?
basicNack额外多一个功能,支持批量 ACK。basicReject是AMQP 0-9-1协议的标准支持。在所有支持该协议的消息队列中间件中都可以使用这个 API,但basicNack只是 RabbitMQ 自己做的一个扩展功能,为了支持批量 ACK。
关于 Multiple 批量消息处理:
true:表示支持批量应答,如队列上有 1、2、3、4 四个消息,消费者 A 收到了这四条,对 4 这个消息进行 ack 时如果设置了 multiple = true,则会自动将之前收到的消息 1、2、3 中未进行过 ack 的消息以当前相同的方式进行 ack。- 优点:在服务稳定时,支持大量的消息处理速度
- 缺点:可能会丢失消息,如消息 2 处理过程中报错了,没有进行 ack,那么在 4 时批量 ack 的话,就会把消息 2 误以为处理成功,造成消息丢失。
false:建议使用这种方式,不批量应答,只是处理当前消息的ACK / NACK
关于消息自动重新入队:
- 如果消费者由于某些原因失去了连接,那么已经接收但未 ACK 的消息,会自动重新入队,避免消息丢失。
- ⭐⭐⭐ 使用
reject / nack将消息重新入队时,消息不会从尾部入队,仍然还是在头部!如果需要在尾部入队,则需要先正常 ACK、然后再publish消息。(这很重要,不然当你拒绝消息后,可能消息还在你这,处理不当会无限循环)
除了 ack / nack / reject 还有 recover 功能,它有两个重载方法:
channel.basicRecover(boolean requeue);让Broker将当前channel未确认的消息重新发送。- 如果
requeue为true,则未被确认的消息会重新入队,这将可能会分配到其他消费者。 - 如果
requeue为false,则同一条消息会被分配给与之前相同的消费者。
- 如果
channel.basicRecover();:默认调用requeue为true的方法。
参考:
- https://www.rabbitmq.com/confirms.html#acknowledgement-modes
- https://www.rabbitmq.com/nack.html
6.2 消息持久化
6.2.1 交换机持久化
队列持久化很简单,在创建交换机时有个参数 durable 来表示是否持久化,且只能在创建时指定,创建后无法修改:
boolean durable = true;
channel.exchangeDeclare(交换机名称, BuiltinExchangeType.DIRECT, durable, false, false, null);
这个持久化指的是,如果 rabbitmq 重启了,交换机是否还存在。注意,如果交换机是非持久化,但队列是持久化的,那么重启后,交换机会消失,同时两者之间如果有绑定关系也会消失。
6.2.2 队列持久化
队列持久化很简单,在创建队列时有个参数 durable 来表示是否持久化,且只能在创建时指定,创建后无法修改:
boolean durable = true;
channel.queueDeclare(队列名, durable, false, false, null);
这个持久化指的是,如果 rabbitmq 重启了,队列是否还存在。注意,如果队列是非持久化,但队列中的消息是持久化的,那么重启后,队列和消息都会消失!
6.2.3 消息持久化
发送消息时有个 BasicProperties props 参数,这个参数中有个属性 deliveryMode 表示消息是否持久化,如发送消息时这个值传递的 null,则消息默认是非持久化的,也就是重启 rabbitmq 的话,消息就会丢失。
BasicProperties 的 deliveryMode 属性有两个办法创建,第一种是通过 builder 来创建:
AMQP.BasicProperties basicProperties =
        new AMQP.BasicProperties
                .Builder()
                .deliveryMode(2) // 1: 非持久化消息 2: 持久化消息
                .build();

channel.basicPublish("",
        queueName,
        true,
        basicProperties, // 消息属性
        "Hello World".getBytes());
也可以通过内置的常量:
AMQP.BasicProperties basicProperties = MessageProperties.PERSISTENT_TEXT_PLAIN;

channel.basicPublish ("",
        queueName,
        true,
        basicProperties, // 消息属性
        "Hello World".getBytes());
其实 MessageProperties.PERSISTENT_TEXT_PLAIN 也是通过创建 BasicProperties 对象,指定 deliveryMode 来生成的,rabbitmq 的 java sdk 中将常用的创建成常量放到 MessageProperties 类中了。
不过这里有个特殊情况,就是当设置为需要持久化的消息刚发送到 rabbitmq 中,但还未写入磁盘成功(此时还在内存中),这时消息也是会丢失的,不过这种属于极端情况了。
6.3 发送确认机制 & 事务机制
前面讲到了消息持久化来解决 rabbitmq 服务崩溃重启后避免消息丢失。但还有个问题,就是如果消息压根都没有到达 RabbitMQ Broker 呢,默认情况下,basicPublish 是没有任何返回的,你不知道到底发出去没有,发送成功没有。如果压根没发送到 Broker,那么消息持久化自然也没有任何意义。
RabbitMQ 提供了两种方案来解决:
- 事务机制(低性能)
- 发送方确认机制
- 同步单个确认(低性能)
- 同步批量确认(中性能)
- 异步确认(高性能)
6.3.1 事务机制
RabbitMQ Java 客户端中,与事务相关的方法有:
channel.txSelect()用于将当前信道设置为事务模式。channel.txCommit()提交当前事务,只要事务提交成功,那么就确保 RabbitMQ 已经确认接收到了消息,且如果开启了持久化,也会确保数据已经落盘。channel.txRollback()回滚事务。
开启事务后就可以发送消息给 RabbitMQ,如果事务提交成功了,消息一定达到了 RabbitMQ 中,如果事务提交前由于 RabbitMQ 异常崩溃或者发送了其他故障,就会抛出异常,这时候可以捕获异常进行回滚或决定要不要重发消息,如:
public static void main (String[] args) throws IOException, TimeoutException {
    String _queueName = "my-queue";
    ConnectionFactory factory = new ConnectionFactory();
    factory.setHost("127.0.0.1");
    factory.setPort(5672);
    factory.setUsername("admin");
    factory.setPassword("123456");

    Connection conn = factory.newConnection();
    // 创建信道
    Channel channel = conn.createChannel();
    // 声明队列
    channel.queueDeclare(_queueName, true, false, false, null);
    String message = String.format("时间 => %s", new Date().getTime());
    try {
        channel.txSelect(); // 声明事务
        // 发送消息
        channel.basicPublish("", _queueName, MessageProperties.PERSISTENT_TEXT_PLAIN, message.getBytes(StandardCharsets.UTF_8));
        int i = 1 / 0; // 抛出 Exception
        channel.txCommit(); // 提交事务
    } catch (Exception e) {
        channel.txRollback();
    } finally {
        channel.close();
        conn.close();
    }
}
6.3.1.1 事务性能
引用 RabbitMQ 官网的一句话:使用标准 AMQP 0-9-1,保证消息不丢失的唯一方法是使用事务 —— 使通道具有事务性,然后针对每条消息或一组消息发布、提交。在这种情况下,事务会非常重量级,会使吞吐量降低 250 倍。为了解决这个问题,引入了确认机制。它模仿协议中已有的消费者确认机制。
我这里实测了一下,虽然没有测出官网所说的极端情况 250 倍的性能差距,但是也不少了:
- 每发送一条开启一个事务并提交,耗时
10982 ms - 每发送一条开启一个事务并回滚,耗时
10526 ms - 所有消息只用一个事务,耗时
538 ms - 所有消息不启用事务,耗时
369 ms
那为什么事务的性能会这么差呢?其实主要原因是事务机制将整个消息流程复杂很多。不启用事务时发送消息的流程为: 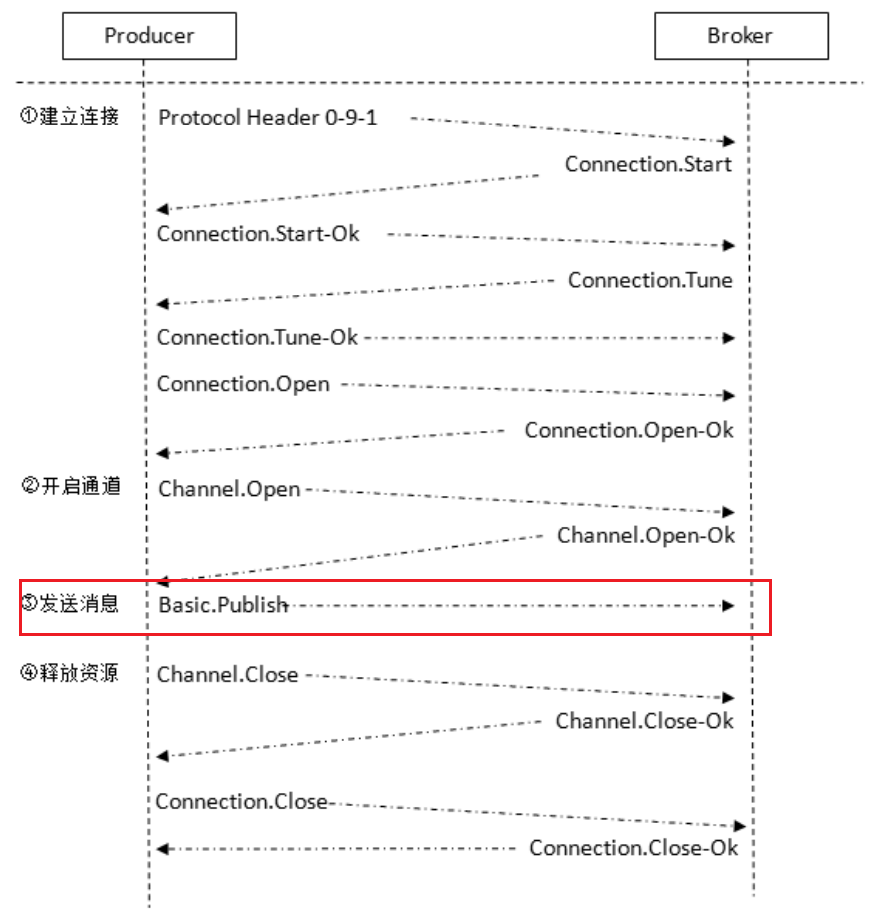 启用后变为:
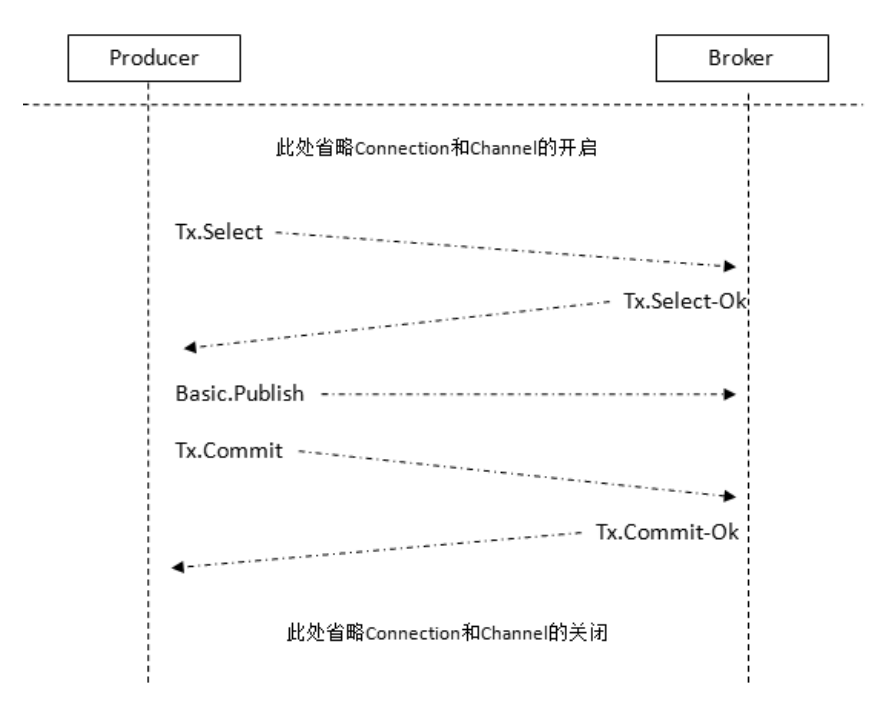
可以发现,每个事务步骤多了四步:
- 客户端发送
Tx.Select,将channel设置为事务模式 Broker回复Tx.Select-Ok,确认已将channel设置为事务模式- 在发送完消息后,客户端发送
Tx.Commit提交事务 Broker回复Tx.Commit-Ok,确保事务提交
6.3.1.2 消费者中使用事务
事务不仅可以用于发送方确认,还可以用于消息接收方。如 channel.txSelect() 开启事务后,创建一个消费者监听队列:
- 不开启
autoAck:对消息做的ack/nack/reject等操作在channel.txCommit()前,消息会一直处于unacked状态。channel.txCommmit后,消息才会将消息按照事务中的操作进行处理。(在事务中接收消息再 rollback 的话,消息会一致处于 unacked 状态,除非事务所在客户端断开连接才会释放。) - 开启
autoAck:事务不支持autoAck模式,在这种模式下使用事务是无效的,无法回滚消息。
6.3.2 发送方确认
由于事务性能很差,所以 RabbitMQ 提供了发送方确认 (confirm) 模式,生产者将 channel 设置为 confirm 模式,一旦 channel 进入这个模式,所有该 channel 发送的消息都有一个唯一的 ID(从 1 开始),当消息被确认投递到 Broker 会返回一个确认消息给生产者(包含消息的唯一 ID),如果开启了持久化,则是数据落盘后返回确认消息。生产者根据这个唯一 ID 就知道了消息是否正确到达目的地。
关于发送方确认的 API 如下:
Confirm.SelectOk channel.confirmSelect():开启发送方确认机制boolean channel.waitForConfirms():判断当前到上次执行waitForConfirms后所有消息都被确认或拒绝,会返回boolean值,没有参数会一直等待broker返回ack | nackboolean channel.waitForConfirms(long timeout):和上面无参的方法相比,多了个 timeout 参数,单位为毫秒,超时未收到 broker 确认结果会抛出TimeoutException异常(虽然抛出了异常,但可能消息也已经被接收,只不过只是超出了限制的时间而已)。void waitForConfirmsOrDie():和waitForConfirms功能一样,只是消息发送未被确认,则会抛出IOException,并关闭当前 channel 连接,接下来将无法发送消息。voide waitForConfirmsOrDie(long time):和上面无法的方法相比,只是增加了超时时间,超时会抛出IOException并关闭当前 channel 连接。
再来看看发送方确认的流程: 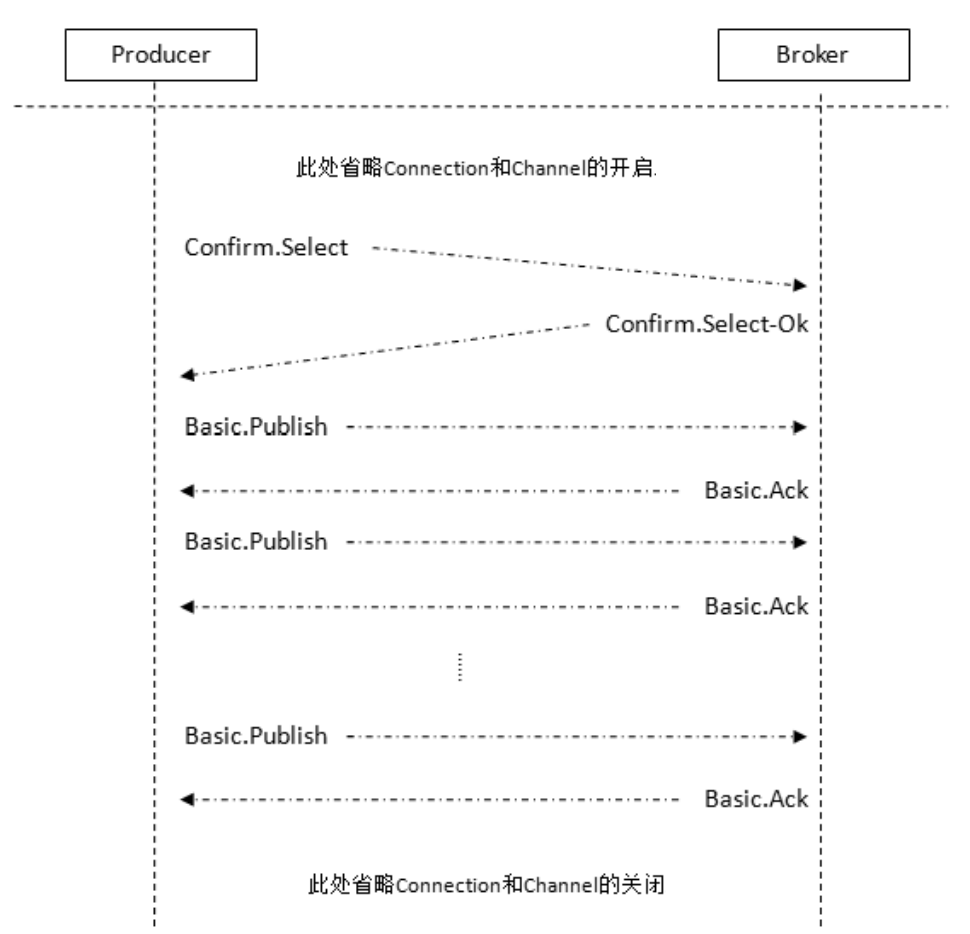 相较于事务模式每次都要开启和提交事务,发送方确认模式只需开启 confirm 模式后,每次正常发送消息即可,Broker 会返回消息确认状态,比事务模式少了一些步骤。
6.3.2.1 同步单个发送确认
channel.confirmSelect();
for (int i = 0; i < 10_000; i++) {
    channel.basicPublish("", "routing-key", null, "hello".getBytes());
    if (!channel.waitForConfirms()) {
        log.error("消息发送失败 => {}", i);
    }
}
可以看到上面代码中,先使用 channel.confirmSelect() 开启了发送方确认机制,然后每次发送一条消息都调用 channel.waitForConfirms() 来同步等待 broker 返回是否确认成功接收到消息。
再次用发送 1w 条数据的方式验证下性能,结果为 5141ms,虽然比事务模式快一倍,但是也还比直接发消息慢了 13 倍。为了优化性能,还可以批量进行发送确认:
6.3.2.2 同步批量发送确认
channel.confirmSelect();
for (int i = 0; i < 10_000; i++) {
    channel.basicPublish("", "routing-key", null, "hello".getBytes());
}

if (!channel.waitForConfirms()) {
    log.error("消息发送失败 => {}", i);
}
这次是直接发送多条数据,最后只调用一次 waitForConfirms,因为他的功能就是判断之前所有未确认的消息是否已确认,所以可以在这里用来批量确认,测试后下性能,耗时为:306ms,可以看到基本和不开启任何机制持平了。
不过需要注意的是,虽然批量确认性能高,但是如果确认失败了,将无法得知到底是哪些条发送失败。
6.3.2.3 异步发送确认
// 存储未确认的消息号
SortedSet<Long> unconfirmedSet = Collections.synchronizedSortedSet(new TreeSet<>());

channel.confirmSelect();
channel.addConfirmListener(new ConfirmListener() {

    @Override
    public void handleAck(long deliveryTag, boolean multiple) throws IOException {
        log.info("ack deliveryTag => {}, multiple: {}", deliveryTag, multiple);
        if (multiple) {
            unconfirmedSet.headSet(deliveryTag + 1).clear();
        } else {
            unconfirmedSet.remove(deliveryTag);
        }
    }

    @Override
    public void handleNack(long deliveryTag, boolean multiple) throws IOException {
        log.info("nack deliveryTag => {}, multiple: {}", deliveryTag, multiple);
        if (multiple) {
            unconfirmedSet.headSet(deliveryTag + 1).clear();
        } else {
            unconfirmedSet.remove(deliveryTag);
        }
        // todo 重发 / 记录日志 / 异常处理
    }
});

for (int i = 0; i < 10_000; i++) {
    long nextPublishSeqNo = channel.getNextPublishSeqNo();
    channel.basicPublish("", "routing-key", null, "hello".getBytes());
    unconfirmedSet.add(nextPublishSeqNo);
}

// 如果有未确认的消息, 则等待.
int maxWaitTime = 1000;
int waitTime = 10;
while (!unconfirmedSet.isEmpty()) {
    if (waitTime > maxWaitTime) {
        log.error("等待确认超时, 未确认消息数量: {}", unconfirmedSet.size());
        break;
    }
    Thread.sleep(waitTime);
    waitTime *= 2;
}

log.info("等待确认完成, 未确认消息数量: {}", unconfirmedSet.size());
可以看到异步确认是创建一个监听器,用来监听服务端返回的 confirm,返回的信息中包含消息的唯一 ID 和 multiple,表示这个唯一 ID 到上次 ack/nack 前的数据 confirm 结果。性能上测试大约为 300 ms 和批量确认模式还有不开启发送确认差不多。实际开发中推荐使用这种方式。
6.3.3 注意事项
需要注意的是:
- 事务机制和 confirm 是互斥的,不支持同时使用。
- 事务机制和 publish confirm 机制确保的是消息能够正常的发送至 RabbitMQ,这里的 "发送至 RabbitMQ" 值的是消息正确的发往 RabbitMQ 交换机,如果此交换机没有匹配的路由,那么消息也会丢失,所以使用这两种机制要确保交换机可以路由到队列。如果要确保消息可以匹配到队列,需要结合
mandatory或备用交换机一起来使用提高消息传输的可靠性。 - 事务机制和单条 confirm 机制虽然性能差,但是胜在开发简单,不需要额外维护状态(这里指的是维护
deliveryTag及缓存未确认的消息),批量 confirm 和事务机制就需要记录下未确认的消息列表,当出现异常时,需要对异常的消息进行处理(一般是批量的),不过因为批量 confirm 还是同步的方法,批量重发时也会导致性能降低。
6.3.4 参考 :
- https://www.rabbitmq.com/tutorials/tutorial-seven-java.html
- https://blog.rabbitmq.com/posts/2011/02/introducing-publisher-confirms/
6.4 消息回退
上一节我们讲到发送方消息确认,可以确认消息是否发送到了 Broker,但还个问题,就是如果 Broker 根据 routingKey 无法路由到对应的队列有没有办法得知呢。可以在发送消息时,设置 mandatory 为 true,那么消息无法路由到队列时 (如 routingKey 写错了,没有对应的队列),那么消息会返回给客户端,反之,如果不设置 mandatory,默认为 false,消息将会静默丢弃。
如:
channel.addReturnListener (new ReturnListener () {
    @Override
    public void handleReturn(int replyCode, String replyText, String exchange, String routingKey, AMQP.BasicProperties properties, byte[] body) throws IOException {
        log.info("replyCode = " + replyCode + ", replyText = " + replyText + ", exchange = " + exchange + ", routingKey = " + routingKey + ", properties = " + properties + ", body = " + Arrays.toString(body));
    }
});
channel.basicPublish ("",  // 交换机名称, 没有指定则使用默认 Default Exchange
                "xxx-queue-name",  // 随便输入一个不存在的 routingKey
                true,  // mandatory 参数设置为 true
                null, // 消息属性,这里先不设置
                "Hello World".getBytes()); // 消息内容
将会在监听器中收到一条消息:
19:55:06.039 [AMQP Connection 127.0.0.1:5672] INFO com.mqtest.basic.RabbitSendTest - replyCode = 312, replyText = NO_ROUTE, exchange = , routingKey = xxx-queue-name, properties = #contentHeader<basic>(content-type=null, content-encoding=null, headers=null, delivery-mode=null, priority=null, correlation-id=null, reply-to=null, expiration=null, message-id=null, timestamp=null, type=null, user-id=null, app-id=null, cluster-id=null), body = [72, 101, 108, 108, 111, 32, 87, 111, 114, 108, 100]6.5 exchange 备机
为了应对 exchange 根据路由找不到 queue 的情况, 除了上面的消息回退机制外, 还可以使用 exchange 备机 模式, 简单点说就是当 exchange 根据路由没有匹配的 queue 时, 会自动转发给 exchange 备机, 一般备机会设置为 fanout 类型, 这样能把所有消息投递到与其绑定的队列中, 备机对应的队列会存储所有无法路由的消息, 也可以用专门的报警程序监听这个队列来做出响应的处理。
设置方法为在创建 exchange 时, 在 argument 中指定 alternate-exchange ,值就是 exchange 备机 的名称。 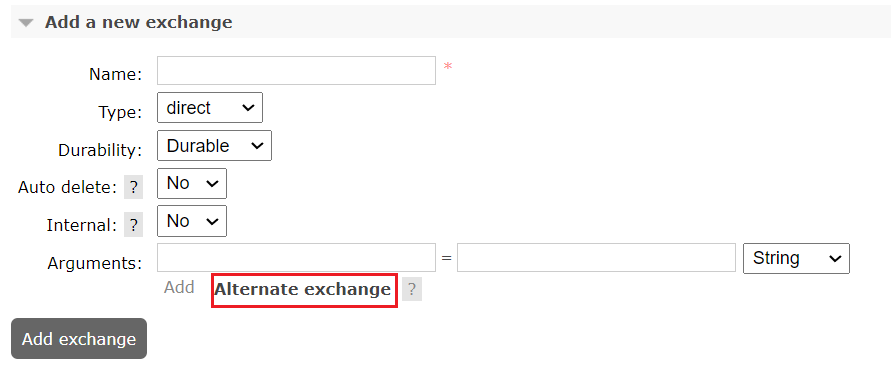
除了根据 routing key 找不到 queue 外,queue 不存在或 queue 满了也会进入备机队列,但是 queue 慢了,不会通过 mandatory return 返回。
exchange 备机比mandatory return模式优先级高,两者同时使用时,mandatory return不会收到消息(不过备用交换机也无法路由到队列时,就没有办法了,且这时mandatory return也不会收到消息的,所以推荐将备用交换机设置为fanout模式)
6.6 消息 100% 送达
要保证消息 100% 送达,需要做很多工作:
exchange、queue、message都要开启持久化。- 发送时做好异常处理,要有重发机制,或记录到数据库采用定时扫描重发的方式。
- 为每条消息记录发送日志,是否发送成功,消息体,消息 deliveryTag 等信息。便于重发时使用。
- 开启事务 / 发布者确认模式来保证消息到达 exchange。
- 发送消息时指定
mandatory开启消息回退模式或使用exchange 备机来处理未成功路由的消息。更推荐使用exchange 备机功能,因为mandatory无法应用于队列满了的清理。 - 消费者避免使用
autoAck功能。 - 开启死信队列功能,当重复消息发送之后仍不能正常消费,把消息发送到死信队列,对于消费失败的消息进行人工干预。
6.7 防止消息重复消费
以下这些情况都可能会造成消息重复消费:
- 消息消费成功,
ack时宕机,导致没有成功ack,broker的消息由unacked变成了ready,又给了其他消费者消费。 - 消费失败时,由于重试机制,自动又将消息重发出去。
解决办法未:消息中携带唯一的 id,并存储到 redis/数据库,当消息重复发送时,检查该全局唯一 id 是否已经被消息过,如果已经被消费过,直接返回 ACK 即可。
6.8 单一活跃消费者
单一活跃消费者(Single Active Consumer)表示队列中可以注册多个消费者,但是只允许一个消费者消费消息,只有在此消费者出现异常时,才会自动转移到另一个消费者进行消费。单一活跃消费者适用于需要保证消息消费顺序性,同时提供高可靠能力的场景。
在创建队列时,可以通过参数 x-single-active-consumer 指定为 true 将队列设置为单一活跃消费者模式。
6.9 消息顺序性
消息顺序性指的是消费者消费到的消息和发送者发送的消息顺序是一致的,如发送 a、b、c 三条消息,消费者接收到的顺序也是 a、b、c。这么一看似乎 RabbitMQ 可以保证消息顺序性,实则不然,有很多情况会打破这个情况:
- 消息通过事务回滚、消息
nack / reject或其他原因导致消息重新入队时,消息的顺序可能会变化。 - 消息设置了优先级,也不会按照原有的顺序接收到,而是按照优先级排序。
- 使用消息 TTL + 死信队列的方式实现的延迟队列,也会打破消息的顺序,在这里,消息的顺序时按照消息 TTL 排序的。
包括但不限于上述的情况都会导致 RabbitMQ 的消息错序。
6.10 消息自动过期
前面死信队列和延迟队列用到了消息自动过期,但是还有很多细节,这里详细说说。
设置消息自动过期有两种方式:
- 通过队列的
x-message-ttl属性来设置,单位为毫秒,表示队列中所有消息默认的有效期。 - 通过消息的
expiration属性来设置,单位为毫秒,表示当前这条消息的有效期。
当同时使用两种方式时,将使用两者中的较低值。
两者还是有很大区别的:
- 前者一旦消息过期,就会从队列中抹去,但后者即使消息过期,也不会马上从队列中抹去,每条消息是否过期是在即将投递到消费者之前判断的。(出现这种差异是因为前者,也就是队列的 TTL 是统一的,队列中过期的消息肯定在队头,RabbitMQ 只需要定期从队头开始扫描直到有未过期的消息停止并删除扫描到已过期的消息即可。但是后者消息自身的过期时间可能各不相同,可能队列中前面的消息的过期时间晚于头部的,想要发现所有过期消息就要遍历整个队列,很消耗性能,所以不如在消息到队头时在投递前进行检查。也就是说,你可能发送了一些消息,在还没有消费到这些消息时,就已经过期了,但是从统计信息来看,还对这些消息进行了计数,且它们仍然占用着空间。)
其他注意事项:
- RabbitMQ 保证已经过期的消息不会投递给消费者,但是在投递的网络传输过程中过期是有可能的。
- 如果不设置 TTL,则表示消息不会过期;如果设置 TTL 为 0,则表示除非可以直接向消息投递给消费者,否则消息将会被丢弃 (或死信)
- 路由到多个队列的消息可能在其队列中不同时间消亡,甚至不消亡。一个队列中的消息的死亡不会影响其他队列中同一条消息的生命周期。
- 如果消息被重新排队(
nack/reject时requeue),将会保留原始的过期时间。换句话说就是不会因为requeue重置ttl时间。
7 RabbitMQ 管理
7.1 多租户与权限
RabbitMQ 中可以创建虚拟主机,简称 vhost。每个 vhost 之间的队列、交换机是独立的,相互隔离的。每个用户至少应有一个 vhost,客户端连接时,也应指定一个 vhost,且 RabbitMQ 中默认提供一个 / 的 vhost。 在 RabbitMQ 中授权是以 vhost 为单位的,用户通常被授予至少一个 vhost,用户只能访问被授予的 vhost。授权的参数有:
vhost:授予用户权限的vhost名称。user:可访问该vhost的用户名conf:匹配用户在哪些资源有可配置权限的正则表达式write:匹配用户在哪些资源有可写权限的正则表达式read:匹配用户在哪些资源有可配置权限的正则表达式
可配置指队列和交换机的创建及删除等操作;可写指发布消息;可读指和消息有关的操作,包括读取消息及清空整个队列。
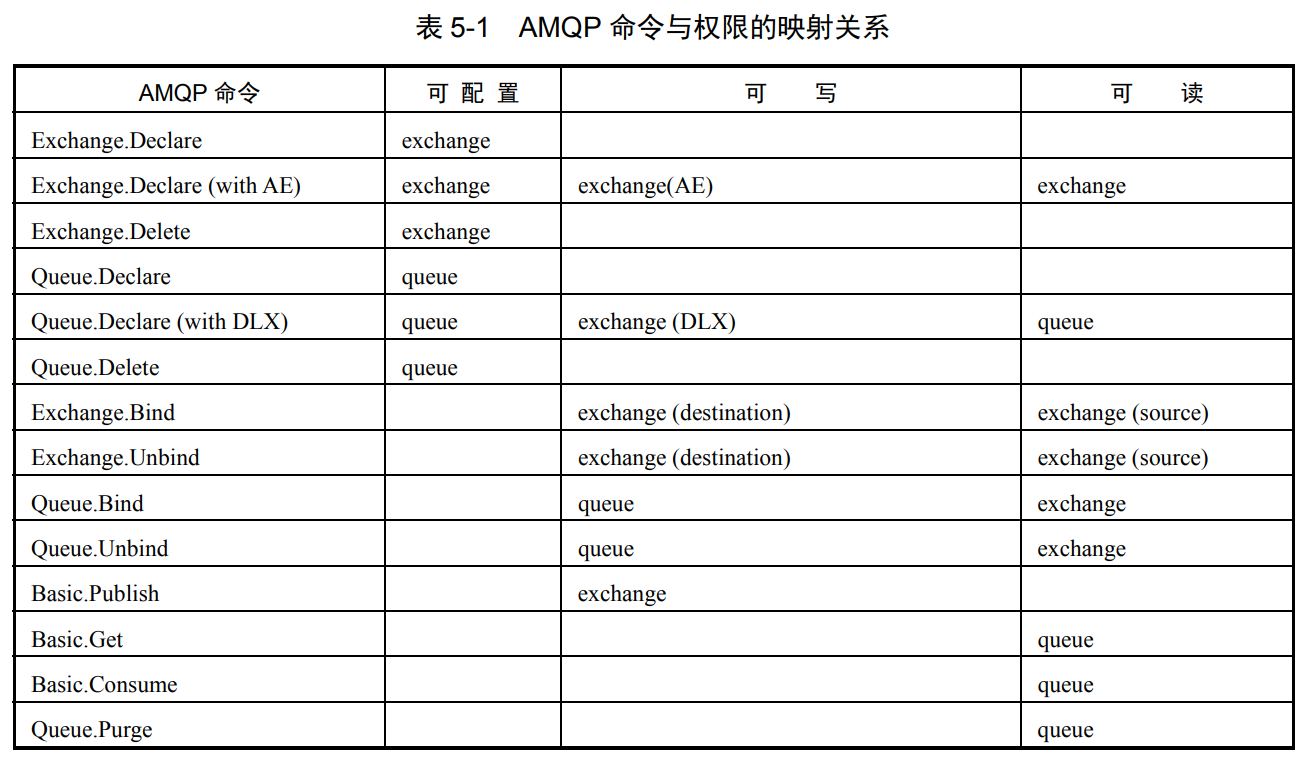
7.2 用户管理
RabbitMQ 中,用户是访问控制的基本单元,一个用户可以被授予多个 vhost,且在不同的 vhost 中可有不同的权限,并使用标准的用户名和密码来认证用户。
创建用户时还可以授予用户角色:
none:无任何角色,新创建的用户的角色默认为none。managment:可以访问 Web 管理页面。policymarker:包含managment的所有权限,并可以管理策略和参数。monitoring:包含managment的所有权限,并可以看到连接、信道、节点相关的信息。administrator:超级管理员,可以做所有操作。